Метод index() в Python возвращает номер первого элемента, равного переданному значению. Запись fruits.index("груша") вернёт позицию первой груши в списке, причём отсчёт идёт с нуля. Если такого значения нет, метод не возвращает -1: он останавливает программу ошибкой ValueError.
Работает он у списков, строк, кортежей и range. У словаря и множества метода нет. Ниже разберём синтаксис, поиск с середины, обработку ошибки и поиск всех позиций значения сразу. Как устроены сами списки, подробно описано в статье о списках в Python.
 CheckroiПодборка курсов по Python570 курсов • 53 школыСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Как работает index(): синтаксис и первый пример
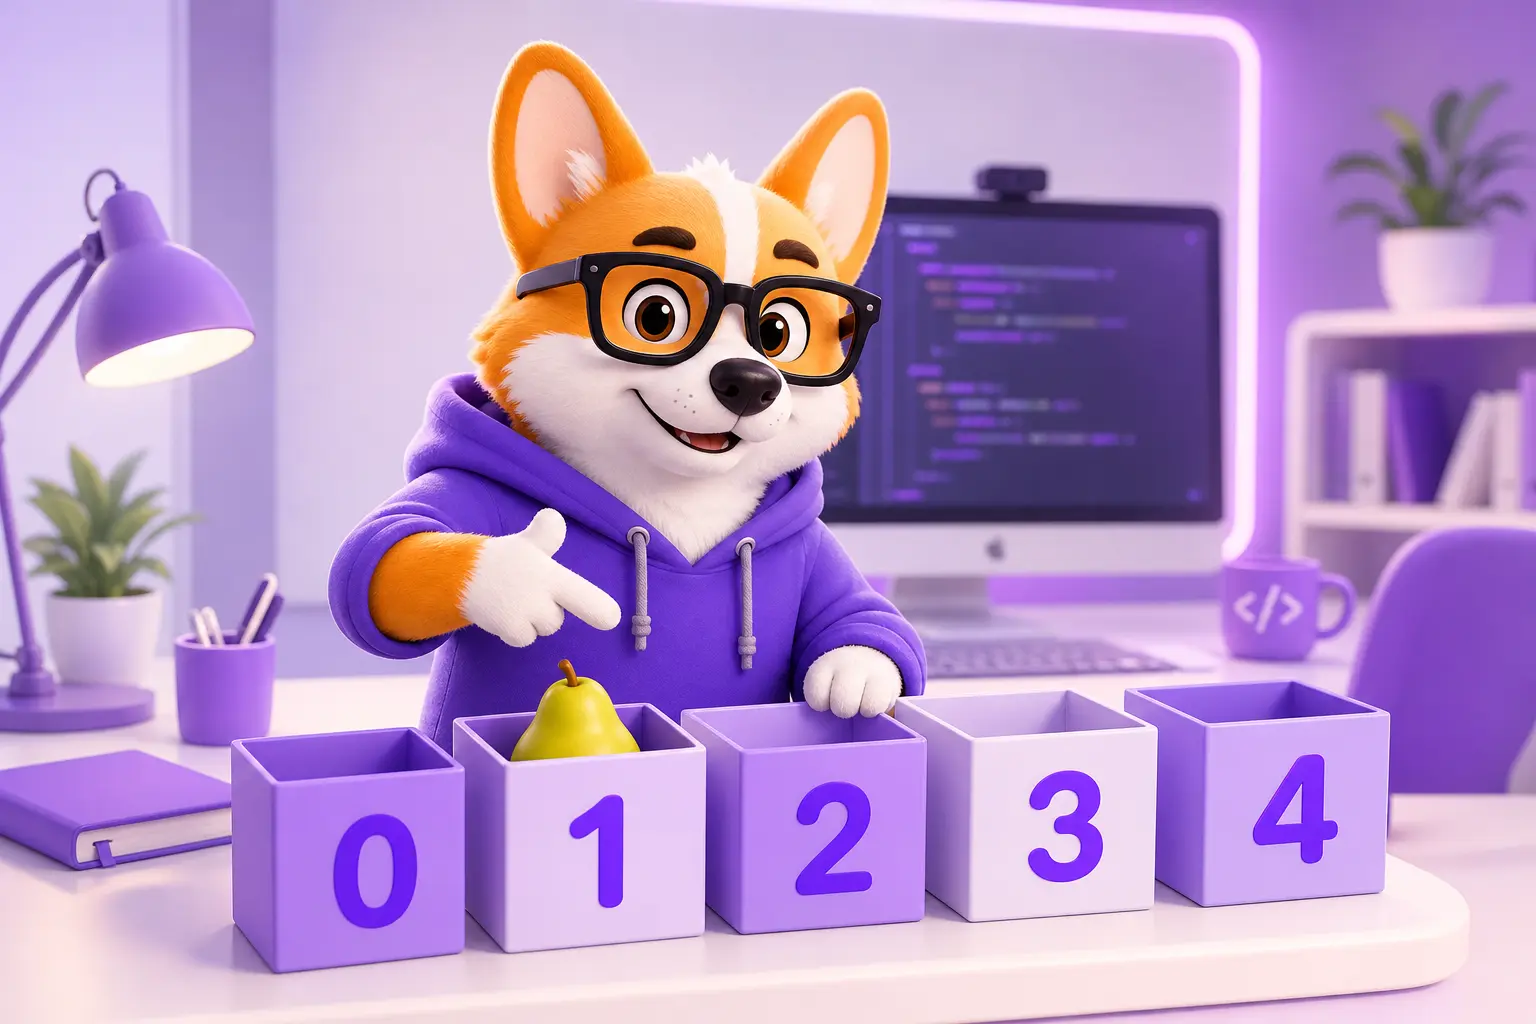
Полная запись выглядит так: последовательность.index(значение, start, stop). Обязателен только первый аргумент, два других сужают поиск. В документации Python сказано, что метод возвращает индекс первого вхождения значения и вызывает ValueError, если такого элемента нет.
Чтобы найти позицию элемента в списке:
- Возьмите список, в котором ищете, например
fruits. - Вызовите у него метод и передайте значение:
fruits.index("груша"). - Сохраните результат в переменную или сразу выведите через
print(). - Если значение может отсутствовать, оберните вызов проверкой. Как это сделать, показано в разделе про ошибку ниже.
fruits = ["яблоко", "груша", "слива", "груша"]
print(fruits.index("груша"))1Груша в списке встречается дважды, на позициях 1 и 3. Метод остановился на первой и дальше не смотрел. Сам список при этом не изменился: index() только читает данные.
Метод сравнивает элементы оператором ==. Поэтому "Груша" с заглавной буквы метод не найдёт, а число 1 найдёт там, где стоит 1.0 или True. К этой ловушке вернёмся в разделе ошибок.
Аргументы start и stop: искать не с начала
Второй и третий аргументы задают, с какой позиции начать поиск и до какой искать. Работают они так же, как границы в срезах списка: start входит в диапазон, stop уже нет.
fruits = ["яблоко", "груша", "слива", "груша"]
print(fruits.index("груша", 2))
print(fruits.index("слива", 0, 3))
3
2В первом вызове поиск начался с позиции 2, поэтому метод пропустил первую грушу и нашёл вторую. Обратите внимание: результат считается от начала всего списка. Вернулось 3, хотя поиск начался с позиции 2.
Ещё три детали, которые легко упустить:
startбывает отрицательным:[3, 1, 3, 2].index(3, -2)вернёт 2, поиск идёт с предпоследнего элемента.stopбольше длины списка ошибки не даёт:[3, 1, 3, 2].index(2, 1, 100)вернёт 3.- Именованные аргументы не принимаются. Запись
nums.index(3, start=1)падает сTypeError: list.index() takes no keyword arguments, передавайте границы по позиции.
index() у строк, кортежей и других коллекций
Метод есть не только у списков. У строки он ищет подстроку и возвращает позицию её первого символа, у кортежа ведёт себя так же, как у списка. Подробнее о поиске внутри текста есть в шпаргалке по методам строк.
text = "сенокос"
print(text.index("о"))
print(text.index("ко"))
print((10, 20, 30).index(30))
print(range(0, 100, 5).index(25))
3
4
2
5Поддержка отличается в мелочах. В разделе об общих операциях последовательностей документация предупреждает, что не все типы последовательностей поддерживают аргументы start и stop. У range так и есть: вызов range(0, 100, 5).index(25, 1) даёт TypeError.
| Тип | Есть index() | start и stop | Если не нашёл |
|---|---|---|---|
list |
да | да | ValueError |
tuple |
да | да | ValueError |
str |
да, ищет подстроку | да | ValueError: substring not found |
range |
да | нет, TypeError |
ValueError |
collections.deque |
да | да | ValueError |
dict, set |
нет, AttributeError |
нет | нет |
У очереди deque метод тоже есть, это видно в описании deque. У словаря и множества нет порядковых номеров, поэтому и метода нет. Как отличать эти типы между собой, разобрано в статье о типах данных Python.
CheckroiПодборка курсов для Python-разработчиков85 курсов • 33 школыСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Что делать, если элемента нет в списке
Пустой результат index() не возвращает. Если значения нет, программа падает:
fruits = ["яблоко", "груша", "слива"]
fruits.index("банан")
ValueError: list.index(x): x not in listТак текст ошибки выглядит в Python 3.14. В Python 3.12 и 3.9 то же исключение пишет само значение: ValueError: 'банан' is not in list. Тип ошибки одинаковый, поэтому код ниже работает в обеих версиях.
Проверить через in
Самый читаемый способ: сначала спросить, есть ли значение, и только потом искать его позицию.
cities = ["Казань", "Пермь", "Омск"]
city = "Томск"
if city in cities:
    print(cities.index(city))
else:
    print("Нет в списке")
Нет в спискеМинус у способа один: список проходится дважды, сначала оператором in, потом методом. На коротких списках разницы не заметить.
Поймать ошибку через try и except
Если важен один проход, вызывайте метод сразу и ловите исключение. Как устроена эта конструкция, есть в разборе try и except в Python.
cities = ["Казань", "Пермь", "Омск"]
try:
    pos = cities.index("Томск")
except ValueError:
    pos = -1
print(pos)-1Для строк есть готовый метод find(): он ищет так же, но при неудаче возвращает -1. В справке по str.find() так и написано, а str.index() там описан как find(), который вызывает ValueError. У списков find() нет.
Как найти все индексы значения, последний индекс и позицию максимума
Метод отдаёт только первое совпадение. Остальные задачи решаются короткими приёмами поверх него или рядом с ним.
Все позиции сразу
Соберите номера через генератор списка и функцию enumerate(): она отдаёт пары «индекс, значение».
nums = [5, 7, 5, 9, 5]
positions = [i for i, n in enumerate(nums) if n == 5]
print(positions)
[0, 2, 4]Если нужно только число совпадений, а не их места, хватит метода count().
Все вхождения подстроки в строке
Со строкой генератор по символам не поможет, если ищете слово из нескольких букв. Здесь удобнее find() в цикле: каждый следующий поиск начинается на символ дальше предыдущей находки, а -1 означает, что совпадений больше нет.
text = "кот и котёнок у котла"
positions = []
start = text.find("кот")
while start != -1:
    positions.append(start)
    start = text.find("кот", start + 1)
print(positions)
[0, 6, 16]Слово «кот» нашлось трижды: отдельно, внутри «котёнка» и внутри «котла». Если нужны только целые слова, понадобятся регулярные выражения.
Последнее вхождение
У списка нет метода, который ищет с конца. Разверните копию срезом [::-1], найдите в ней первое совпадение и пересчитайте номер:
nums = [5, 7, 5, 9, 5, 7]
last = len(nums) - 1 - nums[::-1].index(7)
print(last)5У строк такой метод есть: rindex() ищет справа и тоже вызывает ValueError, если подстроки нет.
Где стоит максимум или минимум
nums = [4, 8, 15, 16, 23, 42]
print(nums.index(max(nums)))
print(nums.index(min(nums)))
5
0Если максимум встречается несколько раз, вернётся позиция первого из них.
Поиск во вложенном списке
В таблице из списков index() сравнивает строки таблицы целиком. Чтобы найти строку по первому столбцу, пройдите по ним с enumerate():
table = [["Москва", 13], ["Казань", 1.3], ["Омск", 1.1]]
print(next(i for i, row in enumerate(table) if row[0] == "Омск"))2Частые ошибки и что с ними делать
Ниже пять ситуаций, в которых index() ведёт себя не так, как ждёт новичок.
- Ждали
-1, получили падение. Привычка из JavaScript или изstr.find(). Решение: проверкаinилиtry/except, как в разделе выше. - Не нашлось слово с другим регистром.
["Аня", "Борис"].index("аня")даётValueError. Решение: приведите обе стороны к нижнему регистру, например найдите позицию в списке[n.lower() for n in names]. - Нашлось не то значение. Python считает равными
0иFalse,1иTrue,1и1.0. Поэтому[0, False].index(False)вернёт 0, то есть позицию нуля. Если типы важны, ищите по условию:next(i for i, x in enumerate(items) if x is False). - Вызвали у словаря.
prices.index("чай")падает сAttributeError: 'dict' object has no attribute 'index'. У словаря значение достают по ключу, для этого есть метод get(). - Программа тормозит в цикле.
index()каждый раз просматривает список с начала. Если вы ищете позиции тысячи раз в большом списке, один раз постройте словарь «значение → индекс».
Последний пункт легко показать замером. Список из 100 000 чисел, тысяча поисков последнего элемента:
import timeit

data = list(range(100_000))
positions = {value: i for i, value in enumerate(data)}

t_list = timeit.timeit(lambda: data.index(99_999), number=1_000)
t_dict = timeit.timeit(lambda: positions[99_999], number=1_000)
print(f"index(): {t_list:.3f} с")
print(f"словарь: {t_dict:.5f} с")
index(): 0.567 с
словарь: 0.00003 сНа вашем компьютере секунды будут другими, но разница останется огромной: в этом замере словарь нашёл позицию примерно в 19 тысяч раз быстрее. Оговорка одна: в словаре останется последний индекс повторяющегося значения, а не первый.
 Канал основателя Checkroi Вани БуявцаЗабирайте промпты и обучение по нейросетям в моём Телеграм-каналеБольше 3 800 человек уже применяют Claude Code, ChatGPT и другие нейросети в работе, учёбе, бизнесе и жизниПерейти в канал
Где освоить Python системно
Метод index() закрывает одну небольшую задачу. Когда таких задач становится много, удобнее один раз пройти структуры данных, исключения и работу с коллекциями по программе с практикой и проверкой кода. В подборке ниже курсы по Python с ценами и сроками, их можно сравнить на одной странице. Все программы собраны в каталоге курсов Python.
| Курс | Школа | Стоимость со скидкой | В рассрочку | Длительность | Обзор курса от Checkroi |
|---|---|---|---|---|---|
| Профессия «Python-разработчик» Перейти на сайт курса |  Skillbox | 157 335 ₽ | 5987 ₽/мес. | 10 месяцев | Обзор курса |
| Fullstack-разработчик на Python Перейти на сайт курса |  Нетология | 137 000 ₽ | 7125 ₽/мес. | 21 месяц | Обзор курса |
| ДО Профессия Python-разработчик Перейти на сайт курса |  GeekBrains | 149 001 ₽ | 3167 ₽/мес. | 10 месяцев | Обзор курса |
| Автоматизированное тестирование на Python Перейти на сайт курса | Skillbox | 118 754 ₽ | 4108 ₽/мес. | 9 месяцев | Обзор курса |
| Профессия Python-разработчик Перейти на сайт курса |  SkillFactory | 140 040 ₽ | 3890 ₽/мес. | 10 месяцев | Обзор курса |
Больше программ — в полном каталоге курсов по Python