

Распределение Пуассона показывает, с какой вероятностью за фиксированный интервал произойдёт ровно k независимых событий, если в среднем их происходит λ. Формула Пуассона: P(X = k) = λk · e−λ / k!. В Python вероятность считается одной строкой: scipy.stats.poisson.pmf(k, λ), а случайную выборку даёт numpy.random.default_rng().poisson(λ, size).
Ниже формула разобрана на примере, который можно пересчитать на бумаге, затем тот же расчёт на SciPy и NumPy, таблица значений, график и проверка реальных данных. Код запускался на Python 3.14, SciPy 1.18 и NumPy 2.5, вывод под каждым блоком настоящий. Если статистика нужна вам для работы, загляните в разбор профессии аналитика данных: Пуассон там встречается почти в каждом отчёте про заказы, обращения и сбои.
 CheckroiПодборка курсов по Python568 курсов • 51 школаСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Что такое распределение Пуассона простыми словами
Это дискретное распределение: случайная величина принимает только целые значения 0, 1, 2, 3 и так далее. Половину заказа или полтора звонка получить нельзя.
У распределения один параметр, λ (лямбда), среднее число событий за выбранный интервал. Интервалом может быть час, смена, страница текста или квадратный метр ткани.
Модель работает, когда выполняются три условия:
- События независимы. Один звонок в поддержку не вызывает следующий.
- Средняя интенсивность постоянна на всём интервале. Если днём заказов втрое больше, чем ночью, считать нужно по отдельным часам, а не по суткам.
- Два события не происходят строго одновременно, а на очень коротком отрезке времени вероятность события мала.
Поэтому Пуассона называют законом редких событий. Каждый посетитель сайта вряд ли купит что-то именно в этот час, но посетителей тысячи, и в сумме выходит несколько заказов.
Где распределение по Пуассону встречается на практике:
- число заказов в интернет-магазине за час;
- обращения в поддержку за смену;
- ошибки 500 на сервере за сутки;
- опечатки на странице и брак в партии деталей;
- звонки в колл-центр, по которым планируют число операторов.
Формула Пуассона и расчёт вручную
Вероятность того, что случайная величина X примет значение k, считается так:
P(X = k) = λ^k · e^(−λ) / k!- λ — среднее число событий за интервал;
- k — число событий, вероятность которого ищем;
- e ≈ 2,718 — основание натурального логарифма;
- k! — факториал: 3! = 1 · 2 · 3 = 6, а 0! = 1.
Пример. Интернет-магазин получает в среднем 3 заказа в час. Какова вероятность, что за ближайший час придёт ровно 2 заказа?
Подставляем λ = 3 и k = 2: 3² · e−3 / 2! = 9 · 0,0498 / 2 ≈ 0,224. То есть примерно в каждом четвёртом-пятом часе заказов будет ровно два.
Ту же функцию Пуассона легко написать на чистом Python, без библиотек. Возведение в степень делает оператор ** (о нём и других знаках есть разбор операторов Python), экспоненту и факториал дают функции exp и factorial из модуля math:
import math

def poisson_pmf(k, lam):
    return lam ** k * math.exp(-lam) / math.factorial(k)

lam = 3  # в среднем 3 заказа в час
for k in [0, 2, 5]:
    print(k, round(poisson_pmf(k, lam), 4))
0 0.0498
2 0.224
5 0.1008Час совсем без заказов случится с вероятностью около 5 %, а пять заказов за час придут примерно в 10 % случаев.
Канал основателя Checkroi Вани Буявца3 700 человек читают мой Телеграм-канал про нейросетиСобрал промпты для Claude Code и ChatGPT, разборы ИИ-инструментов и лайфхаки по продвижению бизнеса в одном местеПрисоединитьсяСвойства распределения Пуассона
Главное свойство, которое пригодится при проверке данных: математическое ожидание и дисперсия равны λ. Оно есть в сводке «Common Statistics» справочника NIST по инженерной статистике: среднее λ, стандартное отклонение √λ. Остальное собрано в таблице.
| Свойство | Значение | Что это даёт на практике |
|---|---|---|
| Математическое ожидание | λ | среднее по данным сразу оценивает параметр |
| Дисперсия | λ | если дисперсия заметно больше среднего, модель не подходит |
| Значения | 0, 1, 2, … | только целые неотрицательные числа |
| Сумма независимых величин | Пуассон с λ₁ + λ₂ | 3 заказа в час дают в среднем 24 заказа за 8 часов |
| Форма | скошена вправо при малом λ | при λ от 10–20 график похож на нормальный |
Формула Пуассона как приближение биномиального распределения
В учебниках по теории вероятностей формулой Пуассона заменяют формулу Бернулли, когда испытаний много, а вероятность успеха мала. Тогда λ = n · p, и считать становится проще.
Проверим на браке: в партии 1000 деталей, каждая бракованная с вероятностью 0,3 %. Сравним точный биномиальный расчёт и пуассоновское приближение с λ = 3:
from scipy.stats import binom, poisson

n, p = 1000, 0.003   # 1000 деталей, брак 0,3 %
lam = n * p
for k in range(6):
    print(k, f"{binom.pmf(k, n, p):.4f}", f"{poisson.pmf(k, lam):.4f}")
0 0.0496 0.0498
1 0.1491 0.1494
2 0.2242 0.2240
3 0.2244 0.2240
4 0.1683 0.1680
5 0.1009 0.1008Расхождение начинается в четвёртом знаке после запятой. Такие сравнения удобно гонять в Jupyter Notebook: меняете n и p в одной ячейке и сразу видите обе колонки. Для задач, где n в сотнях и тысячах, а p меньше 0,01, такой точности хватает с запасом.
Распределение Пуассона в Python
Вероятности считают в SciPy, случайные данные генерируют в NumPy. Обе библиотеки ставятся через pip install scipy numpy matplotlib, удобнее всего в отдельном виртуальном окружении.
Вероятности через scipy.stats.poisson
Объект poisson из модуля scipy.stats принимает параметр mu, это и есть λ. Документация SciPy описывает его как дискретную случайную величину с набором готовых методов:
from scipy.stats import poisson

lam = 3
print(poisson.pmf(2, lam))        # ровно 2 события
print(poisson.cdf(2, lam))        # не больше 2
print(poisson.sf(4, lam))         # больше 4, то есть 5 и выше
print(poisson.ppf(0.95, lam))     # порог, который не превысят в 95 % часов
print(poisson.mean(lam), poisson.var(lam))
0.22404180765538775
0.4231900811268435
0.18473675547622787
6.0
3.0 3.0Первая строка совпала с ручным расчётом. Дальше видно, что не больше двух заказов придёт в 42 % часов, пять и больше придут в 18 % часов, а в 95 % часов заказов будет не больше шести.
| Метод | Что считает | Когда нужен |
|---|---|---|
pmf(k, mu) |
P(X = k) | вероятность ровно k событий |
cdf(k, mu) |
P(X ≤ k) | функция распределения Пуассона, «не больше k» |
sf(k, mu) |
P(X > k) | «больше k», точнее, чем 1 - cdf |
ppf(q, mu) |
наименьшее k, где cdf ≥ q | сколько операторов поставить на смену |
rvs(mu, size=…) |
случайные значения | быстрая симуляция |
logpmf(k, mu) |
логарифм вероятности | большие λ и k, где обычная формула переполняется |
Метод sf SciPy называет функцией выживания и прямо пишет, что она иногда точнее, чем 1 - cdf. Разница заметна на хвостах, где вероятности измеряются тысячными долями и меньше.
Случайная выборка через NumPy
Сгенерировать тысячи значений быстрее в NumPy. В документации NumPy для нового кода советуют метод poisson у генератора вместо старой функции np.random.poisson:
import numpy as np

rng = np.random.default_rng(42)
sample = rng.poisson(lam=3, size=100_000)
print(sample[:10])
print(sample.mean().round(3), sample.var().round(3))
[4 4 5 1 7 1 4 2 2 5]
2.996 3.005На ста тысячах значений среднее и дисперсия почти совпали с λ = 3, как и обещает теория. Число 42 в default_rng фиксирует результат: при повторном запуске выборка будет той же. Так же работает seed() во встроенном модуле random.
Таблица и график распределения Пуассона
Раньше значения брали из таблицы в конце задачника. Теперь таблицу распределения Пуассона для любых λ собирает цикл, а запись f"{p:.4f}" оставляет четыре знака после точки (подробнее в разборе f-строк):
from scipy.stats import poisson

print("k  λ=1     λ=3     λ=5")
for k in range(9):
    row = [poisson.pmf(k, lam) for lam in (1, 3, 5)]
print(k, " ".join(f"{p:.4f}" for p in row))| k | λ = 1 | λ = 3 | λ = 5 |
|---|---|---|---|
| 0 | 0,3679 | 0,0498 | 0,0067 |
| 1 | 0,3679 | 0,1494 | 0,0337 |
| 2 | 0,1839 | 0,2240 | 0,0842 |
| 3 | 0,0613 | 0,2240 | 0,1404 |
| 4 | 0,0153 | 0,1680 | 0,1755 |
| 5 | 0,0031 | 0,1008 | 0,1755 |
| 6 | 0,0005 | 0,0504 | 0,1462 |
| 7 | 0,0001 | 0,0216 | 0,1044 |
| 8 | 0,0000 | 0,0081 | 0,0653 |
Заметна особенность: при целом λ два соседних значения, λ − 1 и λ, одинаково вероятны. В справочнике NIST это записано так: при целом λ модой будут и λ, и λ − 1. У λ = 3 это k = 2 и k = 3, у λ = 5 это k = 4 и k = 5.
График распределения Пуассона строится в matplotlib. Для дискретной величины рисуют точки или столбики, а линия между точками нужна только для того, чтобы глаз отличал серии:
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import poisson

k = np.arange(0, 21)
fig, ax = plt.subplots(figsize=(8, 4.5))
for lam, color in [(1, "#4c72b0"), (4, "#dd8452"), (10, "#55a868")]:
    ax.plot(k, poisson.pmf(k, lam), "o-", color=color, label=f"λ = {lam}")
ax.set_xlabel("k — число событий")
ax.set_ylabel("P(X = k)")
ax.set_title("Распределение Пуассона при разных λ")
ax.set_xticks(k)
ax.legend()
ax.grid(alpha=0.3)
fig.tight_layout()
fig.savefig("poisson.png", dpi=150)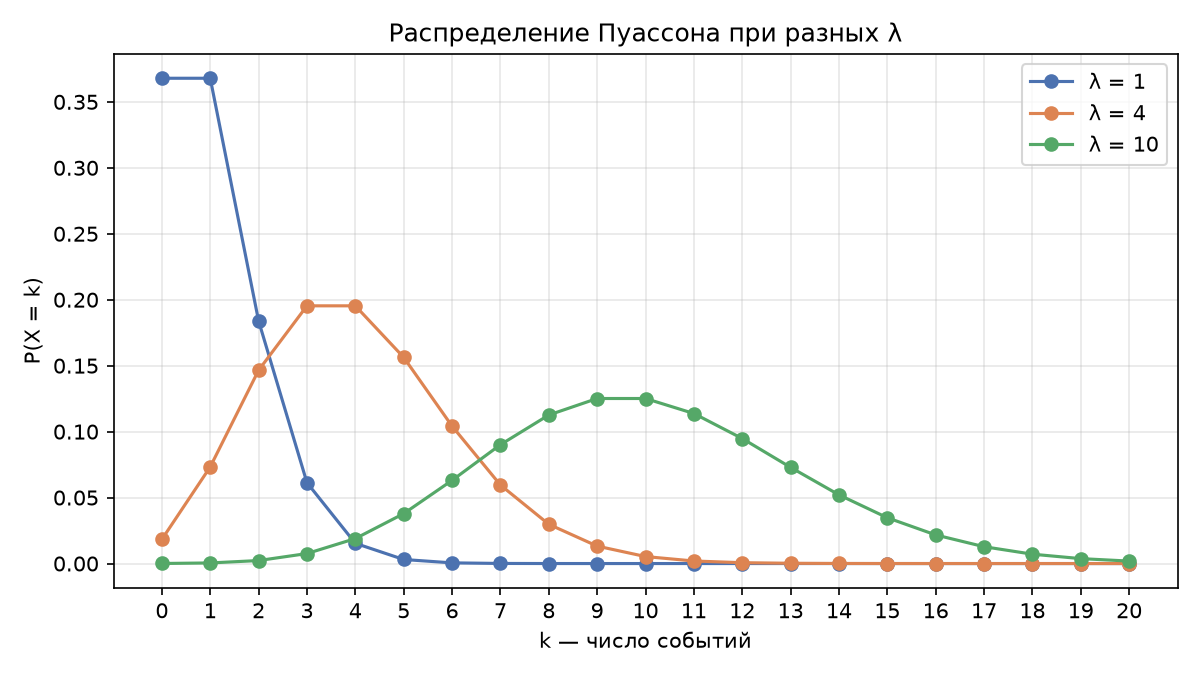
Чем больше λ, тем правее пик и тем шире «колокол». При λ = 1 вероятность быстро падает от нуля, а при λ = 10 график почти симметричен. Поэтому при больших λ Пуассона иногда заменяют нормальным распределением.
Как проверить, что данные подчиняются Пуассону
Перед тем как строить прогноз, проверьте две вещи: близки ли среднее и дисперсия и похожа ли накопленная доля наблюдений на теоретическую кривую.
Индекс дисперсии
Допустим, за 20 часов работы колл-центр записал число звонков в каждом часе. Делим выборочную дисперсию на среднее. У Пуассона отношение должно быть около единицы:
import numpy as np
from scipy.stats import chi2

calls = np.array([2, 4, 3, 0, 5, 3, 2, 6, 1, 3, 4, 2, 3, 5, 1, 2, 4, 3, 2, 3])
m, v = calls.mean(), calls.var(ddof=1)
print(round(m, 2), round(v, 2), round(v / m, 2))

stat = (len(calls) - 1) * v / m          # статистика индекса дисперсии
p = 2 * min(chi2.cdf(stat, len(calls) - 1), chi2.sf(stat, len(calls) - 1))
print(round(stat, 2), round(p, 2))
2.9 2.2 0.76
14.41 0.48Отношение 0,76, а p-значение 0,48. На двадцати часах такое отклонение от единицы объясняется случайностью, и отвергать модель Пуассона повода нет. Если бы отношение вышло 2–3 при сотнях наблюдений, это была бы сверхдисперсия: данные разбросаны сильнее, чем допускает модель.
Эмпирическая функция распределения в Python
Второй способ: сравнить накопленные доли выборки с теоретической функцией распределения. Для этого в SciPy есть scipy.stats.ecdf:
import numpy as np
from scipy.stats import ecdf, poisson

calls = np.array([2, 4, 3, 0, 5, 3, 2, 6, 1, 3, 4, 2, 3, 5, 1, 2, 4, 3, 2, 3])
emp = ecdf(calls).cdf
lam = calls.mean()
for k in range(7):
    print(k, round(float(emp.evaluate(k)), 2), round(poisson.cdf(k, lam), 2))
0 0.05 0.06
1 0.15 0.21
2 0.4 0.45
3 0.7 0.67
4 0.85 0.83
5 0.95 0.93
6 1.0 0.97В среднем столбце доля часов, где звонков было не больше k, в правом та же доля по модели. Самое большое расхождение 0,06 при k = 1, остальные строки отличаются на 0,01–0,05. Логика та же, что у гистограммы распределения в Excel: сначала смотрим на форму данных, потом выбираем модель.
 Канал основателя Checkroi Вани БуявцаЗабирайте промпты и обучение по нейросетям в моём Телеграм-каналеБольше 3 700 человек уже применяют Claude Code, ChatGPT и другие нейросети в работе, учёбе, бизнесе и жизниПерейти в канал
Частые ошибки и что с ними делать
AttributeError: у poisson нет pdf
У дискретных распределений в SciPy вероятность считает pmf, а метода pdf нет. Вызов poisson.pdf(2, 3) падает:
AttributeError: 'poisson_gen' object has no attribute 'pdf'. Did you mean: 'cdf'?Решение: замените pdf на pmf. Подсказка интерпретатора про cdf здесь уводит в сторону.
Перепутаны границы в cdf и sf
cdf(k) включает само k, а sf(k) его не включает. Поэтому «не меньше пяти заказов» считают как poisson.sf(4, 3). Вызов sf(5, 3) вернёт вероятность шести и больше.
Решение: перед расчётом запишите условие знаком: P(X ≥ 5) = P(X > 4) = sf(4).
OverflowError на больших λ
Самописная формула ломается, когда λ и k большие. Для λ = 150 и k = 200 степень 150.0 ** 200 не помещается в число с плавающей точкой:
OverflowError: (34, 'Result too large')Решение: poisson.pmf(200, 150) из SciPy спокойно возвращает 1.5038027878282974e-05, а для совсем малых вероятностей есть logpmf.
Отрицательная или пустая λ
Генератор NumPy требует, чтобы λ была не меньше нуля. В описании метода poisson это сказано прямо, и при lam=-1 он падает с ValueError: lam < 0 or lam is NaN. Чаще всего так выглядит ошибка в данных: среднее посчитали по пустой выборке или с пропусками.
Интенсивность меняется по времени
В 10 утра и в 3 ночи звонков в колл-центр приходит разное число. Если взять одно λ на сутки, модель занизит пики и завысит ночные часы, а дисперсия выйдет больше среднего.
Решение: считайте λ отдельно для каждого часа или дня недели. Если сверхдисперсия остаётся, попробуйте отрицательное биномиальное распределение, в SciPy это scipy.stats.nbinom. Для прогноза по нескольким факторам сразу используют пуассоновскую регрессию.
Где освоить статистику на Python
Распределение Пуассона — одна из первых тем в курсах по анализу данных. За ней идут нормальное распределение, проверка гипотез и A/B-тесты, где те же SciPy и NumPy работают каждый день.
Если хотите разобрать эту базу системно, посмотрите курсы по статистике и по библиотеке NumPy. Ниже программы по анализу данных из нашего каталога:
| Курс | Школа | Стоимость со скидкой | В рассрочку | Длительность | Обзор курса от Checkroi |
|---|---|---|---|---|---|
| Нейросети для рабочих задач Перейти на сайт курса |  Skillbox | 31 290 ₽ | - | 1 месяц | Обзор курса |
| Нейросети. Практический курс Перейти на сайт курса | Skillbox | 74 900 ₽ | - | 3 месяца | Обзор курса |
| Профессия «Аналитик данных с нуля до middle» Перейти на сайт курса |  Нетология | 145 600 ₽ | 6066 ₽/мес. | 12 месяцев | Обзор курса |
| Профессия «Аналитик данных» Перейти на сайт курса | Нетология | 78 100 ₽ | 4156 ₽/мес. | 8 месяцев | Обзор курса |
| Аналитик данных с нуля Перейти на сайт курса | Skillbox | 126 936 ₽ | 4994 ₽/мес. | 4 месяца | Обзор курса |
Больше программ — в полном каталоге курсов по анализу данных