Регрессия — это формула, которая описывает, как одна числовая величина меняется вслед за другими. По этой формуле строят прогноз. Простейший вариант выглядит как y = a + b·x: зная площадь квартиры, получаем ожидаемую цену, зная индекс массы тела, получаем ожидаемый показатель анализа.
Регрессионный анализ находит коэффициенты a и b по реальным данным и говорит, насколько формуле можно верить. Если нужна только сила связи без прогноза, хватит корреляции. В машинном обучении регрессией называют целый класс задач, где ответ выражается числом, и это одна из базовых моделей машинного обучения.
У слова есть и другие значения. В психологии регрессия означает защитный механизм, возврат к детским способам поведения, а в тестировании программ так называют повторную проверку старых функций после правок. Дальше речь только о статистике и анализе данных.
 CheckroiПодборка курсов по анализу данных340 курсов • 53 школыСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Откуда взялось слово и при чём тут рост детей
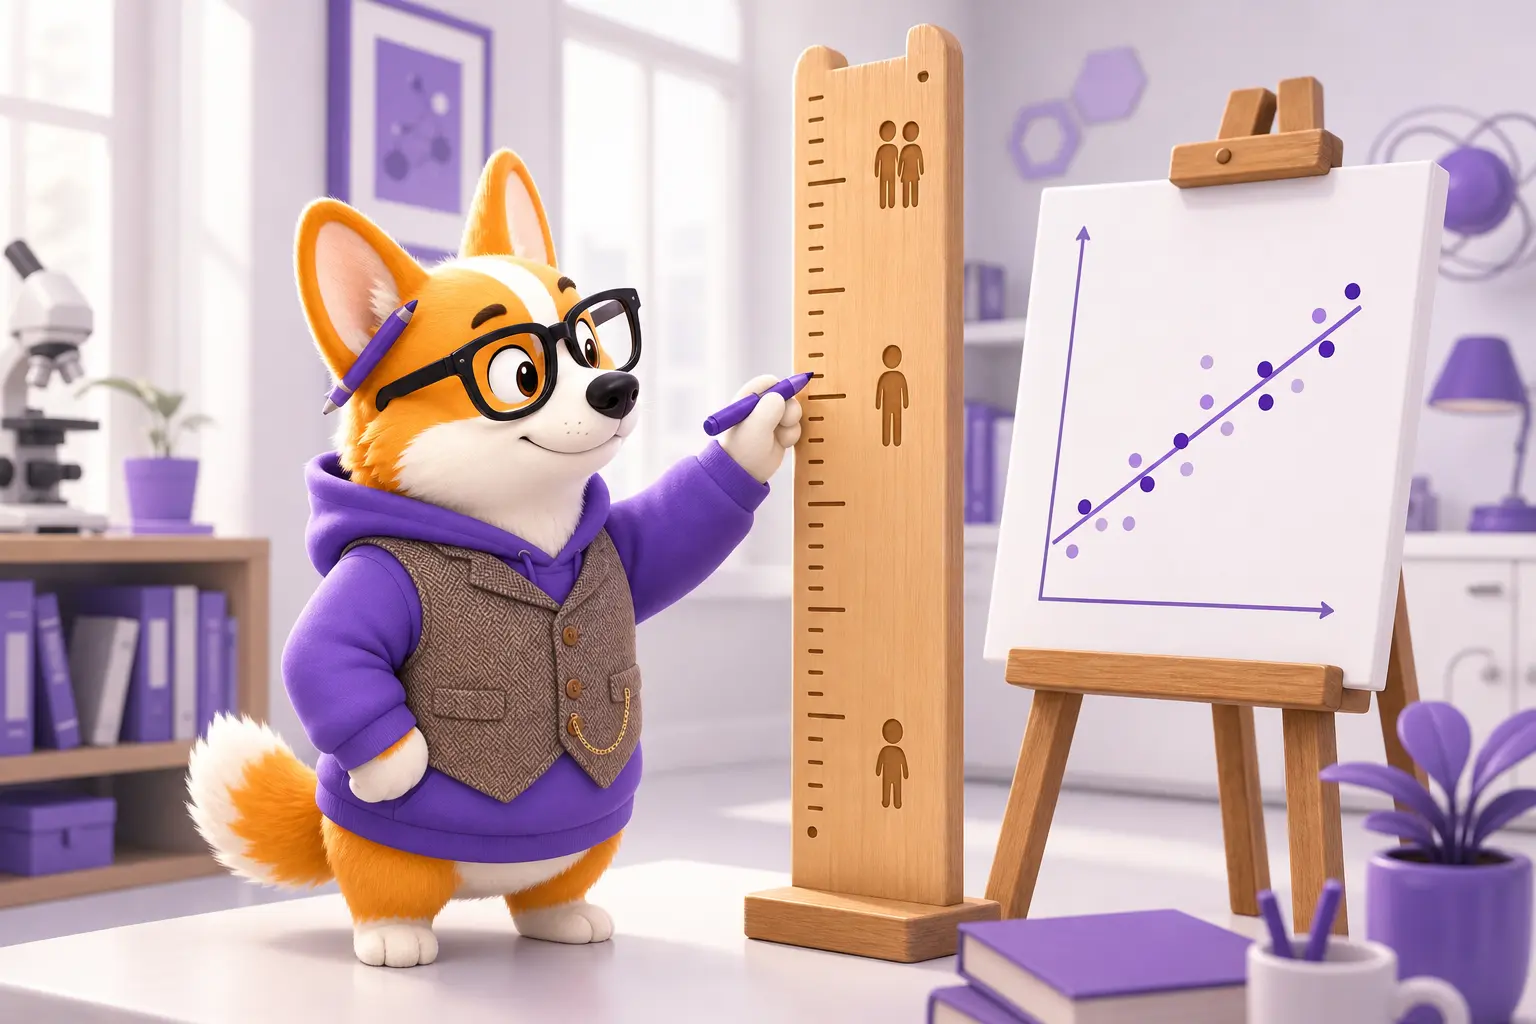
Термин ввёл британский учёный Фрэнсис Гальтон в статье 1886 года «Regression towards Mediocrity in Hereditary Stature» (полный текст на Zenodo). Он сравнивал рост родителей и их взрослых детей и заметил закономерность:
- у самых высоких родителей дети в среднем тоже высокие, но ниже самих родителей;
- у самых низких родителей дети в среднем выше их;
- то есть потомство как бы «откатывается» к среднему росту всей выборки.
Этот откат Гальтон назвал регрессией, от латинского regressio, «движение назад». Сегодня явление называют регрессией к среднему значению, а слово «регрессия» закрепилось за всем методом поиска таких зависимостей.
Регрессия к среднему встречается и в быту. Ученик, который блестяще написал одну контрольную, на следующей чаще всего покажет результат ближе к своему обычному уровню, даже если ничего не изменилось.
Работа статистика и сейчас во многом сводится к построению и проверке таких моделей.
Уравнение регрессии: что означают a и b
Самая простая модель называется парной линейной регрессией. Уравнение линейной регрессии с одним признаком выглядит так:
y = a + b·x + ε| Обозначение | Название | Что показывает |
|---|---|---|
| y | зависимая (целевая) переменная | то, что предсказываем: цену, спрос, выручку |
| x | независимая переменная, признак, фактор | то, от чего зависит y: площадь, цена конкурента, сезон |
| a | свободный член | значение y при x = 0 |
| b | коэффициент регрессии, наклон | на сколько в среднем меняется y, если x вырос на единицу |
| ε | ошибка, остаток | всё, что формула не объяснила |
Коэффициенты подбирают методом наименьших квадратов. Через облако точек проводится такая прямая, у которой сумма квадратов расстояний от точек до неё по вертикали минимальна. Квадраты нужны, чтобы отклонения вверх и вниз не гасили друг друга, а крупные промахи весили больше мелких. Найденную прямую называют функцией регрессии.
Главное в уравнении регрессии: знак и размер b. Положительный наклон означает, что величины растут вместе, а отрицательный говорит, что одна падает, когда другая растёт. Свободный член a часто не имеет житейского смысла, и пример ниже это хорошо показывает.
Пример расчёта на Python с реальными данными
Возьмём открытый датасет о 442 пациентах с диабетом из исследования Эфрона, Хасти, Джонстона и Тибширани 2004 года. Он входит в библиотеку scikit-learn (описание в документации). Целевая переменная здесь означает количественный показатель прогрессирования болезни через год, а признаками служат возраст, пол, индекс массы тела, давление и шесть анализов крови.
Это учебный датасет. Модель на нём показывает, как работает метод, и никаких медицинских выводов из неё делать не стоит.
Построим парную регрессию: прогрессирование болезни от индекса массы тела (ИМТ). Код проверен на Python 3.14 и scikit-learn 1.9.1:
import pandas as pd
from sklearn.datasets import load_diabetes
from sklearn.linear_model import LinearRegression

data = load_diabetes(scaled=False, as_frame=True).frame
X = data[["bmi"]]          # индекс массы тела
y = data["target"]         # прогрессия болезни через год

model = LinearRegression().fit(X, y)
print(f"a (свободный член): {model.intercept_:.1f}")
print(f"b (наклон):         {model.coef_[0]:.2f}")
print(f"R²:                 {model.score(X, y):.3f}")

new = pd.DataFrame({"bmi": [25, 35]})
for bmi, p in zip(new["bmi"], model.predict(new)):
    print(f"Прогноз при ИМТ {bmi}: {p:.0f}")
Вывод:
a (свободный член): -117.8
b (наклон):         10.23
R²:                 0.344
Прогноз при ИМТ 25: 138
Прогноз при ИМТ 35: 240
Как это читать:
- b = 10,23. Каждая лишняя единица ИМТ в этой выборке связана с ростом показателя болезни примерно на 10 пунктов.
- R² = 0,344. Индекс массы тела объясняет около трети разброса. Остальные две трети зависят от того, чего в модели нет.
- a = −117,8. Формально это показатель при ИМТ, равном нулю, но таких людей не бывает, а отрицательного прогрессирования тоже. Свободный член здесь только задаёт положение прямой.
Параметр scaled=False важен: по умолчанию библиотека отдаёт признаки уже нормированными, и тогда ИМТ 25 в прогноз не подставить. Чтобы повторить такой пример, хватит базового Python: его разбирают на любых курсах Python для начинающих.
Многофакторная модель и проверка качества
В многофакторной регрессии признаков несколько: y = a + b₁x₁ + b₂x₂ + … + bₙxₙ. Каждый коэффициент показывает вклад своего фактора при прочих равных. На этом же принципе построено большинство прогнозов в машинном обучении для бизнеса: спрос, отток, стоимость доставки.
Качество регрессионной модели честно проверяют только на данных, которых она не видела. Поэтому выборку делят: на 75 % учат, на 25 % проверяют. Сравним модель на одном ИМТ и на всех десяти признаках:
from sklearn.datasets import load_diabetes
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import r2_score, mean_absolute_error, root_mean_squared_error

data = load_diabetes(scaled=False, as_frame=True).frame
y = data["target"]
X_train, X_test, y_train, y_test = train_test_split(
    data.drop(columns="target"), y, test_size=0.25, random_state=42)

for cols in (["bmi"], list(X_train.columns)):
    m = LinearRegression().fit(X_train[cols], y_train)
    pred = m.predict(X_test[cols])
    print(f"{len(cols):>2} призн.: R² {r2_score(y_test, pred):.3f} | "
          f"MAE {mean_absolute_error(y_test, pred):.1f} | "
          f"RMSE {root_mean_squared_error(y_test, pred):.1f}")
1 призн.: R² 0.317 | MAE 49.8 | RMSE 61.4
10 призн.: R² 0.485 | MAE 41.5 | RMSE 53.4Десять признаков объясняют уже почти половину разброса, а средняя ошибка прогноза упала с 49,8 до 41,5 пункта. Три метрики в выводе стоит знать по именам:
| Метрика | Что считает | Когда смотреть |
|---|---|---|
| R², коэффициент детерминации | долю разброса y, которую объясняет модель | сравнить модели на одних данных |
| MAE, средняя абсолютная ошибка | на сколько в среднем ошибается прогноз, в единицах y | объяснить качество заказчику |
| RMSE, корень из среднеквадратичной ошибки | то же, но крупные промахи весят сильнее | когда большие ошибки особенно дороги |
Из трёх метрик сильнее всего на выбросы реагирует RMSE, потому что ошибки возводятся в квадрат. Если RMSE заметно больше MAE, в данных есть отдельные сильные промахи и их стоит рассмотреть поштучно.
Ещё одна обязательная проверка называется анализом остатков. Остатки, то есть разницы между фактом и прогнозом, должны выглядеть как случайный шум вокруг нуля. Если на графике остатков видна дуга или воронка, линейная формула описывает данные плохо и нужна другая модель. Как читать такие графики и проверять значимость коэффициентов, подробно учат на курсах по статистике.
Какие бывают виды регрессии
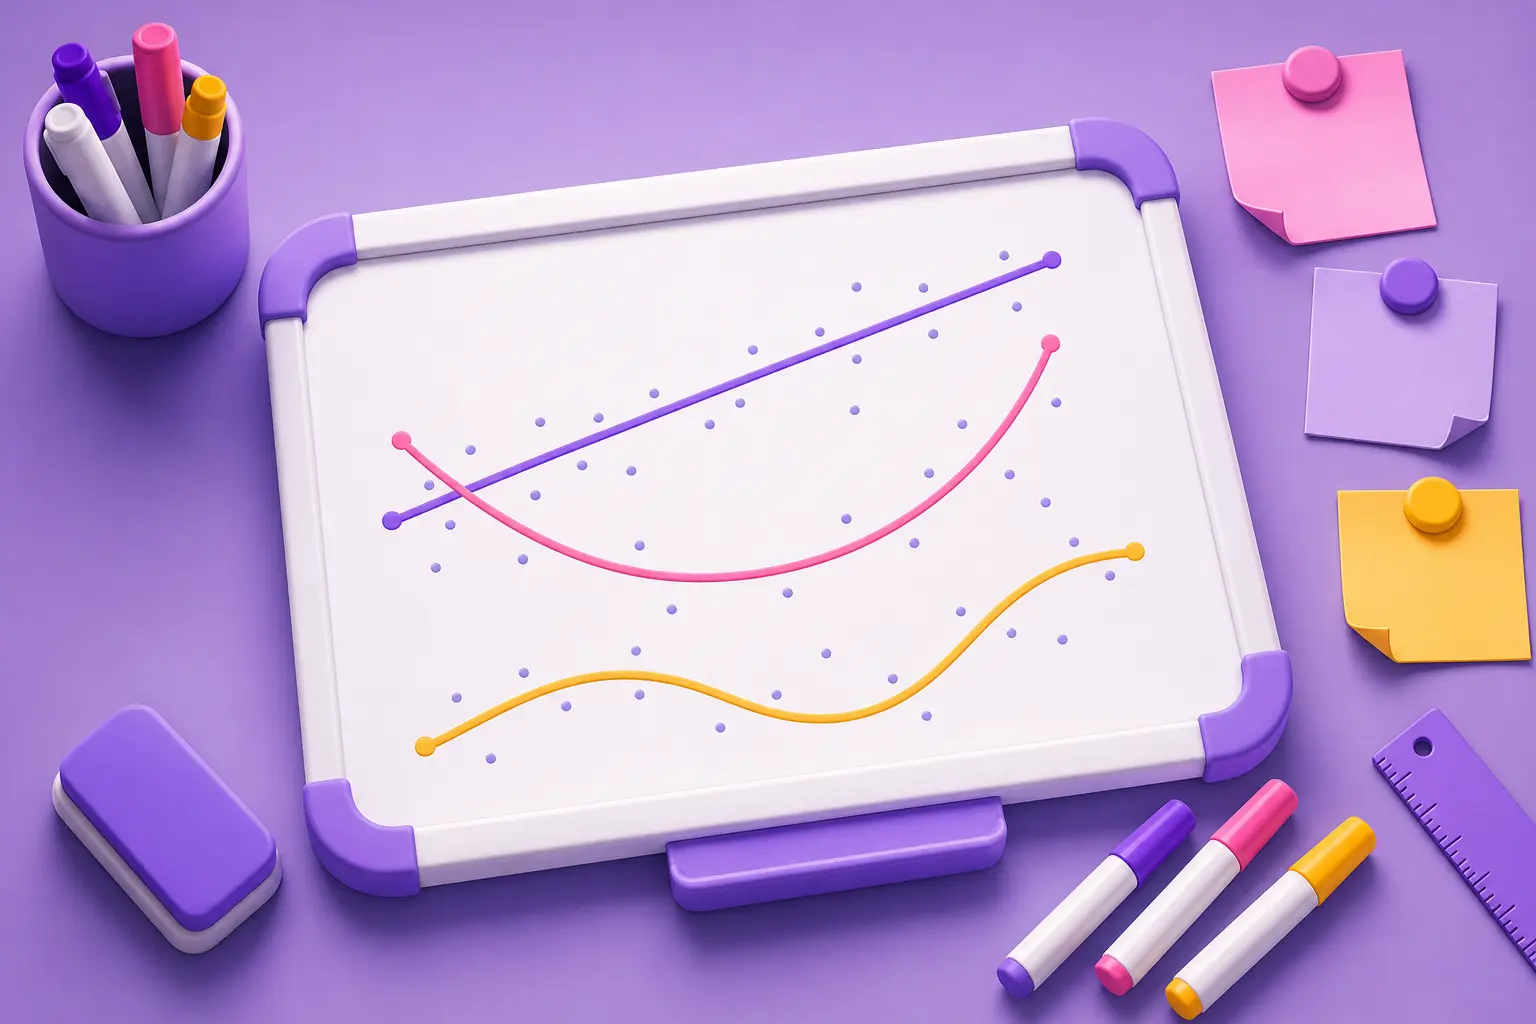
Линейная модель лишь самая простая из семейства. Остальные виды решают её типичные проблемы, и на курсах машинного обучения их обычно проходят в этом же порядке:
| Вид | Чем отличается | Пример задачи |
|---|---|---|
| Парная линейная | один признак, прямая линия | цена квартиры от площади |
| Множественная (многофакторная) | несколько признаков сразу | цена от площади, этажа и района |
| Полиномиальная | в формулу добавляются x², x³, линия изгибается | урожай от количества удобрений, где после пика идёт спад |
| Гребневая (ridge) и лассо | штрафуют слишком большие коэффициенты, лассо умеет обнулять лишние признаки | сотни признаков при небольшой выборке |
| Логистическая | несмотря на название, предсказывает вероятность класса | уйдёт клиент или нет |
| Пуассоновская | прогнозирует счётные величины, которые не бывают отрицательными | число звонков в колл-центр за час |
| Квантильная | предсказывает не среднее, а медиану или другой квантиль | срок доставки, который выполнится в 90 % случаев |
Как лассо отбирает признаки, видно на тех же данных о диабете. Признаки сначала приводятся к одному масштабу, иначе штраф ляжет неравномерно (раздел о линейных моделях в документации scikit-learn):
from sklearn.datasets import load_diabetes
from sklearn.linear_model import Lasso
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline

data = load_diabetes(scaled=False, as_frame=True).frame
X, y = data.drop(columns="target"), data["target"]

lasso = make_pipeline(StandardScaler(), Lasso(alpha=5)).fit(X, y)
for name, c in zip(X.columns, lasso[-1].coef_):
    print(f"{name:>4}: {abs(c) if c == 0 else c:6.1f}")
age: 0.0
sex: -2.2
bmi: 24.2
bp: 10.3
s1: 0.0
s2: 0.0
s3: -7.0
s4: 0.0
s5: 21.2
s6: 0.0Из десяти признаков лассо оставило пять: пол, ИМТ, давление, «хороший» холестерин и триглицериды. Возраст, сахар крови и три других показателя холестерина при таком штрафе модель сочла лишними, потому что их вклад уже покрыт оставшимися признаками. Параметр alpha задаёт силу штрафа: чем он больше, тем больше коэффициентов уходит в ноль.
Чем регрессия отличается от корреляции и классификации
Эти три понятия часто путают, хотя отвечают они на разные вопросы. Если нужна только сила связи, подробнее о ней в статье про корреляцию и её интерпретацию.
| Корреляция | Регрессия | Классификация | |
|---|---|---|---|
| Вопрос | связаны ли величины и насколько сильно | какое число получится при таких входных данных | к какому классу относится объект |
| Результат | один коэффициент от −1 до 1 | формула и числовой прогноз | метка: «да/нет», «кошка/собака» |
| Направление | симметрична, x и y равноправны | есть причина-кандидат и следствие | есть признаки и класс |
| Пример из статьи | ИМТ и прогрессирование болезни связаны с коэффициентом 0,59 | при ИМТ 35 ожидаемый показатель 240 | письмо спам или нет |
В машинном обучении граница проходит по типу ответа. Если ответ выражается числом на непрерывной шкале, это задача регрессии, а если вариантов конечный набор, это классификация. Прогноз выручки на завтра решается регрессией, а прогноз «вырастет выручка или упадёт» уже классификацией. Обе задачи каждый день решает специалист по машинному обучению.
 Канал основателя Checkroi Вани БуявцаЗабирайте промпты и обучение по нейросетям в моём Телеграм-каналеБольше 3 700 человек уже применяют Claude Code, ChatGPT и другие нейросети в работе, учёбе, бизнесе и жизниПерейти в канал
Частые ошибки при построении модели
Формулу посчитает любая программа. Ошибаются обычно на этапе выводов.
- Связь принимают за причину. Продажи мороженого и число утоплений растут вместе, но оба зависят от жары. Регрессия находит согласованное движение, а причину доказывают экспериментом или логикой предметной области.
- Прогнозируют за пределами данных. Модель на квартирах от 30 до 90 м² ничего не знает о пентхаусе на 400 м². Отрицательный свободный член в нашем примере как раз результат такой экстраполяции к ИМТ, равному нулю.
- Не смотрят на выбросы. Одна ошибка ввода вроде цены 15 000 000 вместо 1 500 000 разворачивает прямую. Перед расчётом стоит построить точечный график.
- Добавляют похожие признаки. Если два фактора почти дублируют друг друга, например общая площадь и жилая, коэффициенты начинают прыгать и менять знак. Это называется мультиколлинеарностью, и лечит её отбор признаков или лассо.
- Проверяют модель на тех же данных, на которых учили. Полином десятой степени пройдёт почти через все точки и даст R², близкий к единице, а на новых данных провалится. Это переобучение, и защищает от него отложенная выборка.
Что ещё входит в работу аналитика, кроме расчёта формул, рассказываем в обзоре профессии Data Scientist.
Как посчитать в Excel и Google Таблицах
Для парной регрессии Python не обязателен. Если значения x лежат в A2:A50, а значения y в B2:B50, хватит встроенных функций:
=НАКЛОН(B2:B50;A2:A50)              коэффициент b
=ОТРЕЗОК(B2:B50;A2:A50)             свободный член a
=КВПИРСОН(B2:B50;A2:A50)            R²
=ПРЕДСКАЗ.ЛИНЕЙН(60;B2:B50;A2:A50)  прогноз y при x = 60
=ЛИНЕЙН(B2:B50;A2:A50;ИСТИНА;ИСТИНА) полная статистика
Функция ЛИНЕЙН работает и с несколькими признаками сразу. Она возвращает таблицу: коэффициенты в первой строке идут в обратном порядке, свободный член последним, а R² стоит в третьей строке первого столбца. Синтаксис и порядок вывода описаны в справке Microsoft, в Google Таблицах функция называется так же (справка Google).
В Excel есть и готовый отчёт с остатками и проверкой значимости. Его даёт надстройка «Пакет анализа»:
- Откройте «Файл → Параметры → Надстройки».
- Внизу в списке «Управление» выберите «Надстройки Excel» и нажмите «Перейти».
- Отметьте «Пакет анализа» и нажмите «ОК» (инструкция Microsoft).
- На вкладке «Данные» появится кнопка «Анализ данных», в её списке выберите «Регрессия» и укажите диапазоны y и x.
Если формулы в таблицах пока даются тяжело, системно подтянуть навык помогут курсы по Excel и Google Таблицам.
Где научиться анализу данных
Чтобы понять, что такое регрессия, хватит одного вечера. Чтобы уверенно строить модели на рабочих данных, нужны статистика, Python или SQL и практика на реальных задачах. Если хотите идти в профессию, посмотрите план, как стать статистиком.
Ниже курсы по анализу данных с ценами и программами, отсортированные по рейтингу:
| Курс | Школа | Стоимость со скидкой | В рассрочку | Длительность | Обзор курса от Checkroi |
|---|---|---|---|---|---|
| Нейросети для рабочих задач Перейти на сайт курса |  Skillbox | 31 290 ₽ | - | 1 месяц | Обзор курса |
| Нейросети. Практический курс Перейти на сайт курса | Skillbox | 74 900 ₽ | - | 3 месяца | Обзор курса |
| Профессия «Аналитик данных с нуля до middle» Перейти на сайт курса |  Нетология | 145 600 ₽ | 6066 ₽/мес. | 12 месяцев | Обзор курса |
| Профессия «Аналитик данных» Перейти на сайт курса | Нетология | 101 000 ₽ | 4156 ₽/мес. | 8 месяцев | Обзор курса |
| Аналитик данных с нуля Перейти на сайт курса | Skillbox | 126 936 ₽ | 4994 ₽/мес. | 4 месяца | Обзор курса |
Больше программ — в полном каталоге курсов по анализу данных