Линейная регрессия предсказывает число как сумму признаков, умноженных на коэффициенты, плюс свободный член: y = a + b·x. Коэффициенты подбирают методом наименьших квадратов, то есть так, чтобы сумма квадратов ошибок на обучающих данных была минимальной. В Python это три строки: LinearRegression(), fit(), predict() из библиотеки scikit-learn.
Ниже разберём формулу, посчитаем коэффициенты вручную, повторим расчёт в scikit-learn и градиентным спуском, оценим качество модели и пройдём по ошибкам, на которых новички теряют больше всего времени. Если слово «регрессия» пока звучит незнакомо, начните с общего разбора регрессии в анализе данных: там история термина и пример с Excel.
 CheckroiПодборка курсов по машинному обучению150 курсов • 28 школСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Что такое линейная регрессия и как выглядит её формула
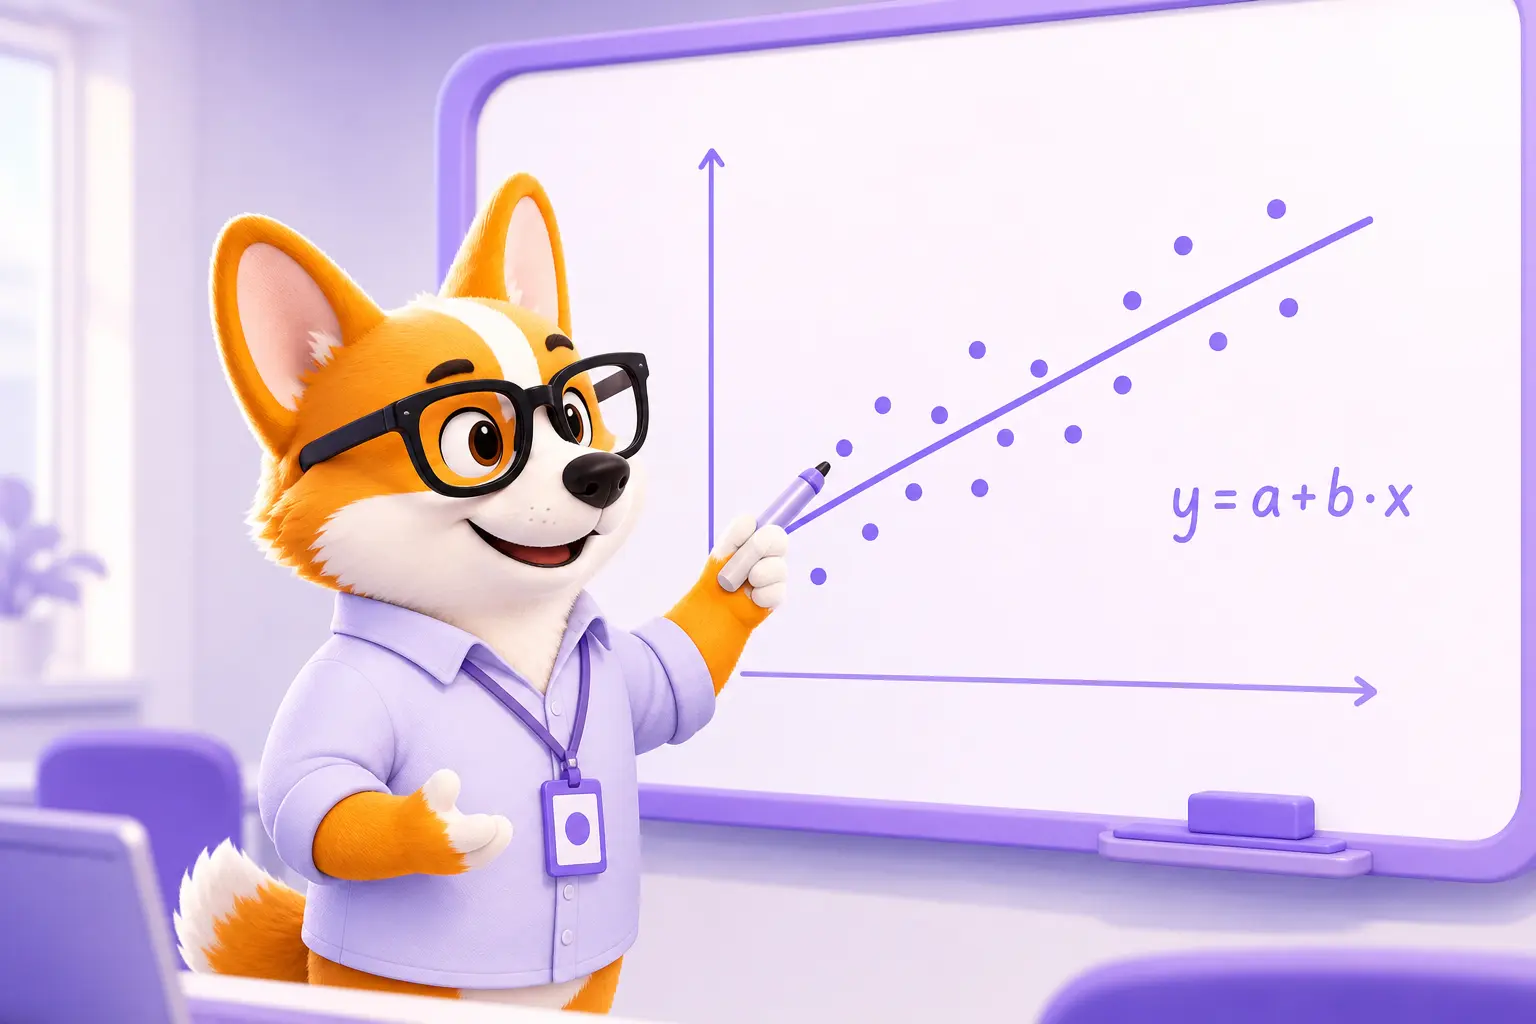
Это модель обучения с учителем: у вас есть примеры, где известны и признаки, и правильный ответ, и модель учится восстанавливать ответ по признакам. Ответ всегда число: цена квартиры, выручка за месяц, время доставки. Если нужно угадать класс («спам или нет»), берут классификацию, о ней ниже.
Для одного признака формула простая:
y = a + b · x, где x обозначает признак, y прогноз, b наклон прямой, а a свободный член, то есть значение прогноза при x = 0.
Если признаков несколько, каждый получает свой вес, и формула превращается в множественную линейную регрессию: y = w₀ + w₁·x₁ + w₂·x₂ + … + wₙ·xₙ. Геометрически это уже не прямая, а плоскость или гиперплоскость, но смысл тот же.
| Термин | Что означает | Как называется в scikit-learn |
|---|---|---|
| Признак (x) | То, по чему предсказываем: площадь, возраст, бюджет рекламы | колонка матрицы X |
| Целевая переменная (y) | То, что предсказываем | вектор y |
| Коэффициент, наклон (b, w) | На сколько меняется прогноз, когда признак растёт на единицу | coef_ |
| Свободный член (a, w₀) | Прогноз при нулевых признаках | intercept_ |
| Остаток | Разница между фактом и прогнозом на конкретном примере | y - model.predict(X) |
Линейная регрессия близка к корреляции, но отвечает на другой вопрос. Корреляция говорит, насколько тесно две величины связаны, а регрессия даёт формулу, по которой одну можно посчитать из другой. Подробнее о разнице и типичных ловушках рассказано в статье о том, как считать корреляцию.
Как модель находит коэффициенты: метод наименьших квадратов
Через облако точек можно провести сколько угодно прямых. Метод наименьших квадратов (МНК, по-английски ordinary least squares) выбирает ту, у которой сумма квадратов остатков минимальна. Квадрат нужен, чтобы ошибки вверх и вниз не гасили друг друга, а крупные промахи штрафовались сильнее мелких.
Среднее этой суммы называют MSE (mean squared error, среднеквадратичная ошибка):
MSE = (1/n) · Σ (yᵢ − ŷᵢ)², а ŷᵢ означает прогноз модели для i-го примера.
Для одного признака у задачи есть точное решение, его выводят в любом учебнике статистики:
- Наклон: b = Σ (xᵢ − x̄)(yᵢ − ȳ) / Σ (xᵢ − x̄)².
- Свободный член: a = ȳ − b · x̄, x̄ и ȳ здесь средние значения.
Для многих признаков то же решение записывают в матричном виде: w = (XᵀX)⁻¹ Xᵀ y. Это и есть аналитическое решение линейной регрессии: никаких итераций, одна формула.
Считаем вручную на реальных данных
Возьмём набор diabetes, который входит в scikit-learn и скачивать его не нужно. По описанию в документации, в нём 442 пациента с диабетом, десять исходных показателей (возраст, пол, индекс массы тела, среднее давление и шесть анализов сыворотки крови) и целевую величину: количественную меру прогрессирования болезни через год. Набор взят из статьи Эфрона, Хасти, Джонстона и Тибширани «Least Angle Regression» в Annals of Statistics за 2004 год, ссылка на неё есть в том же описании.
Предскажем прогрессирование болезни по одному признаку, индексу массы тела (ИМТ). Формулы выше переводятся в код почти дословно:
from sklearn.datasets import load_diabetes

X, y = load_diabetes(return_X_y=True, scaled=False)
x = X[:, 2]                  # индекс массы тела, кг/м²

x_mean, y_mean = x.mean(), y.mean()
b = ((x - x_mean) * (y - y_mean)).sum() / ((x - x_mean) ** 2).sum()
a = y_mean - b * x_mean

print(f"Пациентов: {len(x)}")
print(f"b = {b:.2f}")
print(f"a = {a:.2f}")
Вывод:
Пациентов: 442
b = 10.23
a = -117.77
Читается так: каждая лишняя единица ИМТ в среднем добавляет к мере прогрессирования около 10 пунктов. Свободный член −117,77 смысла сам по себе не имеет: ИМТ, равного нулю, не бывает, а в данных он лежит от 18 до 42,2. Об этом подробнее в разделе про ошибки.
Параметр scaled=False возвращает признаки в исходных единицах. По умолчанию scikit-learn отдаёт их нормированными, и тогда наклон выходит 949,44, что для человека нечитаемо.
Линейная регрессия на Python в scikit-learn: пошагово
Вручную формулу пишут один раз, чтобы понять механику. В работе берут класс LinearRegression: по документации scikit-learn, это обычный МНК, который подбирает коэффициенты так, чтобы минимизировать сумму квадратов остатков.
- Установите библиотеку:
pip install scikit-learn. NumPy подтянется сам. - Подготовьте X и y. X всегда двумерный: в строках примеры, в колонках признаки. Даже если признак один, нужна таблица из одной колонки, отсюда
X[:, [2]]с двойными скобками. - Создайте модель и обучите её методом
fit(X, y). - Посмотрите коэффициенты в атрибутах
coef_иintercept_. - Получите прогноз методом
predict()и оцените качество методомscore().
from sklearn.datasets import load_diabetes
from sklearn.linear_model import LinearRegression

X, y = load_diabetes(return_X_y=True, scaled=False)
X_bmi = X[:, [2]]            # двумерный массив из одной колонки

model = LinearRegression()
model.fit(X_bmi, y)

print(f"b = {model.coef_[0]:.2f}")
print(f"a = {model.intercept_:.2f}")
print(f"R² = {model.score(X_bmi, y):.3f}")
print(f"Прогноз при ИМТ 30: {model.predict([[30]])[0]:.0f}")
Вывод:
b = 10.23
a = -117.77
R² = 0.344
Прогноз при ИМТ 30: 189
Коэффициенты совпали с ручным расчётом до сотых, значит, формулы выше и scikit-learn делают одно и то же. Метод score() у LinearRegression возвращает коэффициент детерминации R². Значение 0,344 означает, что один ИМТ объясняет около трети разброса в прогрессировании болезни. Дальше добавим остальные признаки и посмотрим, сколько это даст.
Данные из CSV удобнее грузить через pandas: df = pd.read_csv("data.csv"), затем X = df[["площадь"]] и y = df["цена"]. Как работать с таблицами, выбирать колонки и чистить пропуски, разобрано в обзоре библиотеки pandas.
Градиентный спуск для линейной регрессии
Формула (XᵀX)⁻¹ Xᵀ y хороша, пока данных немного. Когда признаков тысячи, а строк миллионы, обращать матрицу дорого, и коэффициенты ищут по шагам, градиентным спуском. Тем же приёмом обучают нейросети, например свёрточные сети для картинок, поэтому на линейной регрессии его удобнее всего понять.
Идея: начинаем с a = 0 и b = 0, считаем ошибку, смотрим, в какую сторону её уменьшает изменение каждого коэффициента (это и есть градиент MSE), и делаем маленький шаг туда. Размер шага задаёт скорость обучения (learning rate).
import numpy as np
from sklearn.datasets import load_diabetes

X, y = load_diabetes(return_X_y=True)
x = X[:, 2]

a, b = 0.0, 0.0
lr = 0.5                      # шаг обучения
n = len(x)

for step in range(1, 10_001):
    y_pred = a + b * x
    error = y_pred - y
    grad_a = 2 / n * error.sum()
    grad_b = 2 / n * (error * x).sum()
    a -= lr * grad_a
    b -= lr * grad_b
    if step in (1, 100, 1_000, 10_000):
        mse = (error ** 2).mean()
        print(f"шаг {step:>7}: a = {a:7.2f}, b = {b:7.2f}, MSE = {mse:8.1f}")
Вывод:
шаг       1: a =  152.13, b =    2.15, MSE =  29074.5
шаг     100: a =  152.13, b =  192.43, MSE =   5192.8
шаг    1000: a =  152.13, b =  850.86, MSE =   3912.5
шаг   10000: a =  152.13, b =  949.44, MSE =   3890.5
К десятитысячному шагу спуск пришёл к тем же коэффициентам, что даёт scikit-learn на нормированных данных (949,44 и 152,13). В колонке MSE стоит ошибка до обновления коэффициентов на этом шаге.
Свободный член встал на место за один шаг. Причина в данных: в нормированной версии набора каждый признак центрирован, то есть его среднее равно нулю (так сказано в описании набора), и оптимальное a просто равно среднему y. На ненормированных признаках так не будет.
Градиентный спуск чувствителен к масштабу признаков, поэтому здесь мы взяли нормированную версию. На сырых значениях ИМТ от 18 до 42 тот же шаг 0,5 не сходится: мы проверили, к шестой итерации MSE вырастает с 29 тысяч до 10³².
Множественная регрессия и оценка качества модели
Один признак объяснил треть разброса. Возьмём все десять и оценим модель честно: на данных, которых она не видела при обучении. Для этого выборку делят на обучающую и тестовую часть.
from sklearn.datasets import load_diabetes
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import r2_score, mean_absolute_error, root_mean_squared_error

X, y = load_diabetes(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

model = LinearRegression().fit(X_train, y_train)
y_pred = model.predict(X_test)

print(f"Обучающих: {len(X_train)}, тестовых: {len(X_test)}")
print(f"R² на тесте:  {r2_score(y_test, y_pred):.3f}")
print(f"MAE на тесте: {mean_absolute_error(y_test, y_pred):.1f}")
print(f"RMSE на тесте: {root_mean_squared_error(y_test, y_pred):.1f}")
Вывод:
Обучающих: 353, тестовых: 89
R² на тесте:  0.453
MAE на тесте: 42.8
RMSE на тесте: 53.9
На тесте R² вырос с 0,344 до 0,453. Если посчитать R² на тех же данных, на которых модель училась, выйдет 0,528, но такой цифре верить нельзя: модель видела ответы. Именно поэтому качество проверяют на отложенной выборке.
| Метрика | Что показывает | Как читать наш результат |
|---|---|---|
| R² | Какую долю разброса y объясняет модель | 0,453: почти половину |
| MAE | Средняя ошибка по модулю, в единицах y | прогноз ошибается в среднем на 42,8 пункта |
| RMSE | Корень из MSE, сильнее штрафует крупные промахи | 53,9 при MAE 42,8: часть промахов заметно крупнее средней |
Про R² полезно помнить одно свойство. В документации r2_score сказано: лучший возможный результат 1,0, а значение может быть отрицательным, потому что модель может оказаться сколь угодно хуже. Модель, которая всегда предсказывает среднее y, получает ровно 0. Отрицательный R² на тесте означает, что ваша модель проигрывает даже такому прогнозу.
Где линейная регрессия стоит среди других алгоритмов и когда её пора менять на деревья или бустинг, мы разбирали в обзоре моделей машинного обучения.
Допущения модели и график остатков
МНК всегда выдаст какие-то коэффициенты, даже если линейная модель данным не подходит. Поэтому после обучения проверяют, выполняются ли допущения, на которых построена модель:
- Линейность. Зависимость y от признаков примерно прямая. Если связь изогнутая, добавляют квадраты признаков или берут другую модель.
- Независимость наблюдений. Строки не повторяют друг друга и не идут цепочкой во времени. Для временных рядов это допущение нарушается чаще всего.
- Одинаковый разброс остатков (гомоскедастичность). Ошибка не должна расти вместе с прогнозом.
- Нормальность остатков. Важна, если вы считаете доверительные интервалы и p-значения, для самого прогноза менее критична. Как читать p-значение и не обмануться, разобрано в статье про A/B-тесты.
- Нет сильной мультиколлинеарности. Признаки не повторяют друг друга.
Про последний пункт в руководстве scikit-learn по линейным моделям сказано прямо: оценки МНК опираются на независимость признаков. Когда признаки коррелированы, оценка становится сильно чувствительной к случайным ошибкам в целевой переменной. На практике это выглядит так: добавили похожий признак, и коэффициенты прыгнули, а знак у одного сменился.
Что показывает график остатков
График остатков строят как точечную диаграмму, где по горизонтали прогноз, а по вертикали остаток. У хорошей модели точки лежат ровной полосой вокруг нуля. Воронка, которая расширяется вправо, говорит о растущем разбросе. Дуга говорит о нелинейной связи, которую прямая не уловила.
Ту же проверку можно сделать числами, без картинки:
import numpy as np
from sklearn.datasets import load_diabetes
from sklearn.linear_model import LinearRegression

X, y = load_diabetes(return_X_y=True)
model = LinearRegression().fit(X, y)
residuals = y - model.predict(X)

print(f"Средний остаток: {residuals.mean():.2f}")
low = model.predict(X) < np.median(model.predict(X))
print(f"Разброс остатков, малые прогнозы:   {residuals[low].std():.1f}")
print(f"Разброс остатков, большие прогнозы: {residuals[~low].std():.1f}")
Вывод:
Средний остаток: -0.00
Разброс остатков, малые прогнозы:   46.7
Разброс остатков, большие прогнозы: 59.4
Средний остаток равен нулю, так и должно быть у МНК со свободным членом. А вот разброс у больших прогнозов примерно на 27 % выше, чем у малых: признак той самой воронки. Для учебного примера это допустимо, но в реальной задаче стоит попробовать логарифм целевой переменной.
 Канал основателя Checkroi Вани БуявцаЗабирайте промпты и обучение по нейросетям в моём Телеграм-каналеБольше 3 800 человек уже применяют Claude Code, ChatGPT и другие нейросети в работе, учёбе, бизнесе и жизниПерейти в канал
Частые ошибки и что с ними делать
Одномерный массив вместо таблицы
Симптом: fit() падает с ошибкой:
ValueError: Expected 2D array, got 1D array instead:Причина: передали X[:, 2] вместо X[:, [2]].
Решение: двойные скобки или x.reshape(-1, 1), как подсказывает само сообщение об ошибке.
Прогноз за пределами данных
Модель из примера выше честно ответит на вопрос про ИМТ 10:
print(f"Прогноз при ИМТ 10: {model.predict([[10]])[0]:.0f}")
# Прогноз при ИМТ 10: -15
Отрицательного прогрессирования болезни не бывает. В обучающих данных ИМТ лежал от 18 до 42,2, и за этими границами прямая продолжается, а реальная зависимость нет.
Решение: не экстраполировать далеко, а если приходится, проверять прогноз здравым смыслом.
Слишком большой шаг градиентного спуска
Тот же спуск на нормированных данных, но со скоростью 1,5 вместо 0,5:
шаг 1: a = 456.4, MSE = 29074.5
шаг 2: a = -456.4, MSE = 98480.7
шаг 3: a = 1369.2, MSE = 376188.6
шаг 4: a = -2282.0, MSE = 1487102.4
шаг 5: a = 5020.4, MSE = 5930838.6
Коэффициент скачет через оптимум, и с каждым шагом всё дальше.
Решение: уменьшить шаг в несколько раз и нормировать признаки, например через StandardScaler.
Коэффициент как причина
Коэффициент 10,23 при ИМТ говорит, что у пациентов с большим индексом прогрессирование в среднем выше. Он не доказывает, что снижение веса на единицу ИМТ снизит меру на 10 пунктов: на неё могут влиять другие факторы, связанные с весом. Причинность проверяют экспериментом, регрессия на наблюдениях её не даёт.
Линейная регрессия для классификации
Если закодировать классы как 0 и 1 и обучить LinearRegression, модель будет выдавать и числа больше единицы, и отрицательные, а вероятностью они не являются. Для классов берут логистическую регрессию: она пропускает ту же линейную комбинацию через сигмоиду и возвращает вероятность от 0 до 1.
Когда линейной регрессии мало
У базовой модели есть родственники, которые чинят её слабые места. Названия встретятся в любом курсе по машинному обучению:
| Модель | Что меняет | Когда брать |
|---|---|---|
| Ridge | Штрафует большие коэффициенты (L2-регуляризация) | Признаки коррелированы, коэффициенты нестабильны |
| Lasso | Штраф L1, обнуляет лишние коэффициенты | Признаков много, нужно отобрать важные |
| Полиномиальная регрессия | Добавляет квадраты и произведения признаков | Связь изогнутая, а модель хочется оставить простой |
| Логистическая регрессия | Переводит линейную комбинацию в вероятность | Нужно предсказать класс, а не число |
Все четыре в scikit-learn вызываются так же, как LinearRegression: fit(), predict(), score(). Освоив одну модель, вы почти бесплатно получаете остальные. Обзор видов регрессии с примерами есть в статье о регрессии, а с чего начинать путь в профессии, рассказывает материал о том, как стать ML-инженером.
Где освоить машинное обучение системно
С линейной регрессии начинается почти любая программа по Data Science, дальше идут деревья, бустинг и нейросети. Если хотите пройти этот путь с наставником, проектами и проверкой кода, сравните курсы по машинному обучению: в подборке ниже цены, длительность и рейтинги школ.
| Курс | Школа | Стоимость со скидкой | В рассрочку | Длительность | Обзор курса от Checkroi |
|---|---|---|---|---|---|
| Machine Learning с нуля до Junior Перейти на сайт курса |  Skillbox | 123 543 ₽ | 4384 ₽/мес. | 9 месяцев | Обзор курса |
| Бакалавриат «Data Science & Machine Learning» Перейти на сайт курса | Skillbox | 75 000 ₽ | - | 48 месяцев | Обзор курса |
| Машинное обучение Перейти на сайт курса |  Нетология | 48 000 ₽ | 2598 ₽/мес. | 10 месяцев | Обзор курса |
| Machine Learning. Basic Перейти на сайт курса |  OTUS | 60 000 ₽ | 8613 ₽/мес. | 6 месяцев | Обзор курса |
| Machine Learning Engineer с нуля Перейти на сайт курса | Skillbox | 69 000 ₽ | - | 9 месяцев | Обзор курса |
Больше программ — в полном каталоге курсов по машинному обучению
Если вы только выбираете направление, прочитайте, чем занимается Data Scientist и какие задачи он решает каждый день.