

Юникод присваивает номер каждой букве, цифре и эмодзи: у буквы «Ж» это U+0416. UTF-8 записывает этот номер байтами. Латиница занимает 1 байт, кириллица 2, большинство иероглифов 3, эмодзи 4.
Чтобы текст не превращался в кракозябры, сохраняйте файлы в UTF-8 и указывайте кодировку явно: <meta charset="utf-8"> в HTML, encoding="utf-8" в Python. Ниже всё это на примерах кода с выводом.
Если слово «кодировка» встречалось вам рядом с Base64, это другая задача: Base64 переводит байты в текст, а UTF-8 переводит символы в байты.
 Рекомендуем курсы по Javascript
 SkillboxJavaScript65 744 ₽3 месяца
 OTUSFullstack разработчик JavaScript75 000 ₽6 месяцев
 GeekBrainsФакультет fullstack JavaScript134 700 ₽15 месяцев
 ЭдюсонFullstack-разработчик на JavaScript158 760 ₽11 месяцев
 HexletАвтоматизатор тестирования на JavaScript60 000 ₽6 месяцев
 TeachMeSkillsАвтоматизированное тестирование на JavaScript80 000 ₽4 месяца
Чем Юникод отличается от UTF-8
Оба слова стоят в одном меню, поэтому их путают. Но вопросы у них разные: Юникод отвечает, какой номер у символа, а UTF-8 решает, какими байтами этот номер записать.
| Юникод | UTF-8 | |
|---|---|---|
| Что это | стандарт: таблица символов и их номеров | правило, как записать номер байтами |
| В чём измеряется | кодовые точки от U+0000 до U+10FFFF | байты, на символ от 1 до 4 |
| Буква «Ж» | U+0416 | D0 96 |
| Где описано | стандарт Юникода | RFC 3629 |
Номер символа записывают как U+ и шестнадцатеричное число. В Unicode HOWTO из документации Python кодовая точка определена как целое число от 0 до 0x10FFFF: это около 1,1 млн значений, и занята из них только часть.
В Python номер символа возвращает функция ord(), а chr() делает обратное: ord("Ж") даст 1046, то есть 0x416. Если Python для вас новый, начните с первых примеров кода.
В версии Юникода 18.0 от сентября 2026 года закодировано больше 172 тысяч символов. Кириллице отведён блок U+0400–U+04FF.
Способов записать одну и ту же таблицу несколько: UTF-8, UTF-16, UTF-32. Поэтому в списке кодировок любого редактора рядом стоят UTF-8, UTF-16 LE и UTF-16 BE. Символы у них общие, байты разные.
Как UTF-8 записывает символ в байты
Длина записи зависит от номера символа. Схема взята из той же спецификации, буквой x обозначены биты номера:
| Номера символов | Байт | Шаблон | Что туда попадает |
|---|---|---|---|
| U+0000–U+007F | 1 | 0xxxxxxx | латиница, цифры, знаки ASCII |
| U+0080–U+07FF | 2 | 110xxxxx 10xxxxxx | кириллица, греческий, иврит, арабский |
| U+0800–U+FFFF | 3 | 1110xxxx 10xxxxxx 10xxxxxx | большинство иероглифов, знак € |
| U+10000–U+10FFFF | 4 | 11110xxx и три байта 10xxxxxx | эмодзи, редкие письменности |
По первым битам байта видно, сколько байт у символа, а каждый следующий байт начинается с 10. Если программа попала в середину текста, она пропустит хвостовые байты и найдёт начало следующего символа.
Пример: как кодируется буква «Ж»
- У «Ж» номер U+0416, в двоичном виде 100 0001 0110. Значащих бит 11.
- 11 бит попадают во второй диапазон, значит, нужно 2 байта по шаблону 110xxxxx 10xxxxxx.
- Первые 5 бит (10000) уходят в первый байт: 11010000, это D0.
- Оставшиеся 6 бит (010110) уходят во второй: 10010110, это 96.
Проверить себя можно в Python. Код печатает символ, его номер, байты UTF-8 в шестнадцатеричном виде и их количество. Если шестнадцатеричная запись пока непривычна, помогут системы счисления в Python.
for ch in ["A", "Ж", "ы", "€", "😀"]:
    data = ch.encode("utf-8")
    print(ch, f"U+{ord(ch):04X}", data.hex(" ").upper(), len(data))
A U+0041 41 1
Ж U+0416 D0 96 2
ы U+044B D1 8B 2
€ U+20AC E2 82 AC 3
😀 U+1F600 F0 9F 98 80 4UTF-8, UTF-16, UTF-32 и Windows-1251
Ниже сколько байт занимает один символ в разных кодировках. Цифры посчитаны тем же encode() в Python 3.14.
| Кодировка | «A» | «Ж» | «😀» | Где встречается |
|---|---|---|---|---|
| UTF-8 | 1 | 2 | 4 | сайты, JSON, исходный код |
| UTF-16 | 2 | 2 | 4 | строки внутри JavaScript |
| UTF-32 | 4 | 4 | 4 | редко, когда нужна одинаковая длина символа |
| Windows-1251 | 1 | 1 | не записать | старые русские файлы и сайты |
Windows-1251 однобайтовая: в ней 256 мест, их хватает на латиницу и кириллицу. Эмодзи или китайский текст в неё не записать вообще.
По данным W3Techs на 21 октября 2026 года, UTF-8 используют 99,1 % сайтов, у которых известна кодировка, а Windows-1251 только 0,1 %. Для JSON стандарт однозначен: RFC 8259 требует UTF-8, когда JSON передают между системами вне одной закрытой экосистемы. Подробнее о формате читайте в статье что такое JSON.
UTF-8 победил за счёт совместимости. Английский текст в нём побайтно совпадает с ASCII, так что старые программы на латинице не ломаются. И у него нет вариантов LE и BE, как у UTF-16: порядок байтов один.
Откуда берутся кракозябры
Кракозябры появляются, когда файл записан в одной кодировке, а прочитан в другой. Байты при этом целы, ошибается тот, кто их читает.
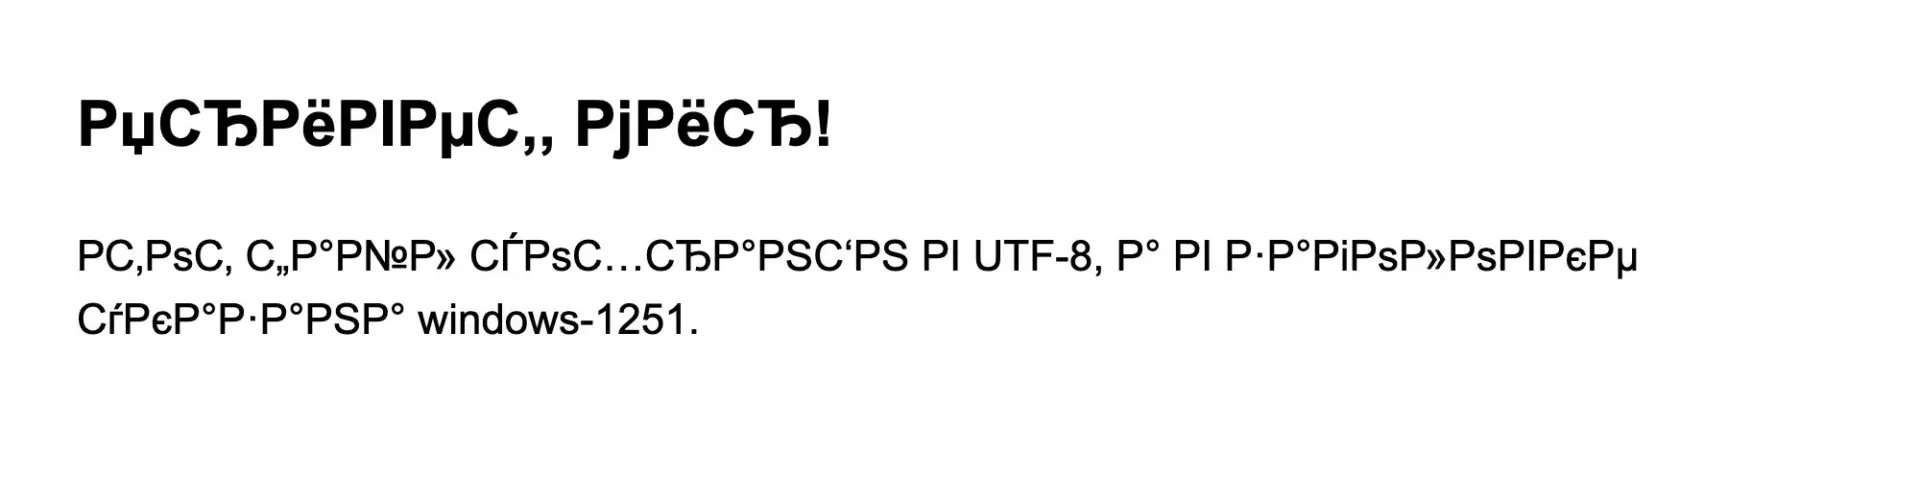
Чаще всего UTF-8 открывают как Windows-1251. Русская буква в UTF-8 занимает 2 байта, а Windows-1251 видит в каждом байте отдельную букву. Слово «Привет» из 6 букв превращается в 12 знаков:
text = "Привет"
print(len(text))
print(len(text.encode("utf-8")))
print(text.encode("utf-8").decode("cp1251"))
6
12
ПриветТак выглядит в Chrome страница, сохранённая в UTF-8, если в её заголовке указана windows-1251:
Обратная ситуация: файл в Windows-1251 читают как UTF-8. Для UTF-8 такие байты недопустимы, и вместо букв появляется знак вопроса в ромбе:
data = "Привет".encode("cp1251")
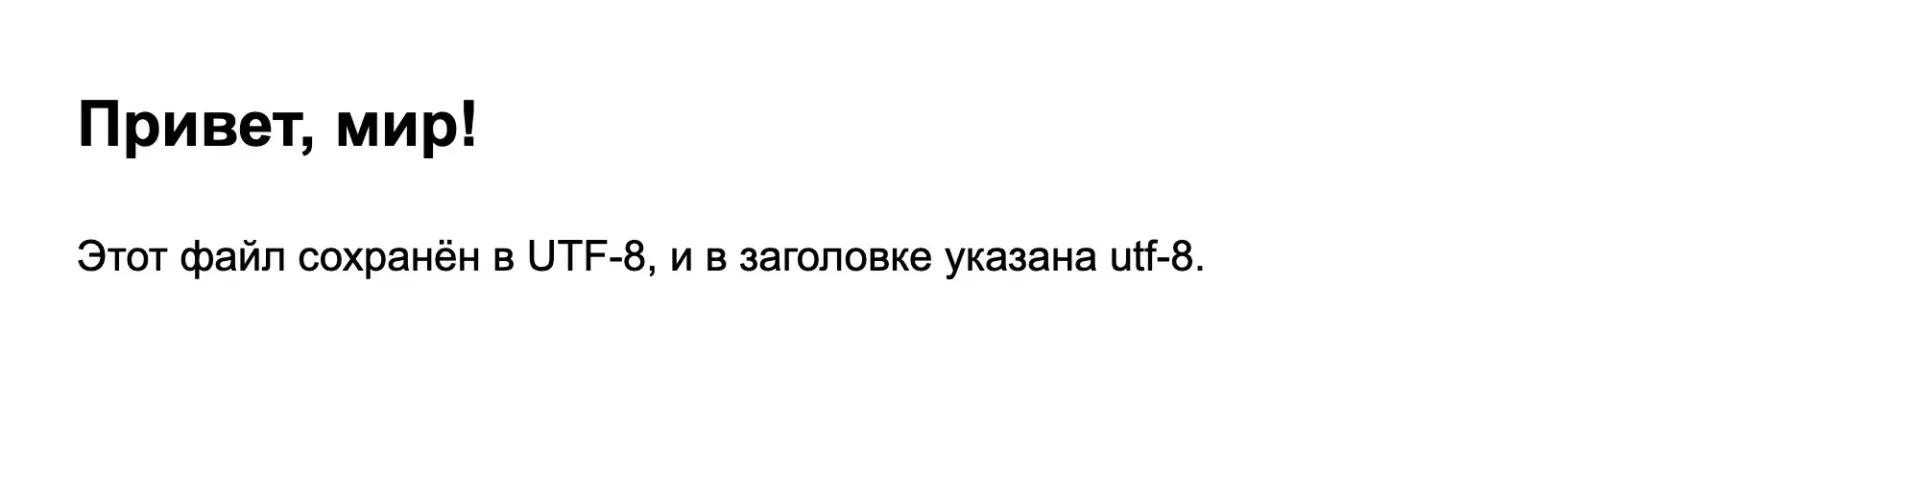
print(data.decode("utf-8", errors="replace"))������Решение одно: открыть файл в той кодировке, в которой он записан, и пересохранить в UTF-8. Для страницы из примера достаточно поправить заголовок, байты трогать не нужно:
 CheckroiПодборка курсов по Javascript209 курсов • 37 школСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Как сохранить файл в UTF-8
Кодировку показывает и меняет любой текстовый редактор. Вот где это делается в трёх самых частых программах.
VS Code
Кодировка открытого файла написана в строке состояния внизу справа. По документации VS Code, щелчок по ней позволяет открыть файл заново в другой кодировке или пересохранить его в новой.
У нового, ещё не сохранённого файла VS Code сразу показывает список «Выберите кодировку файла для его сохранения». Кадр ниже снят в vscode.dev, браузерной версии редактора, с русским интерфейсом.
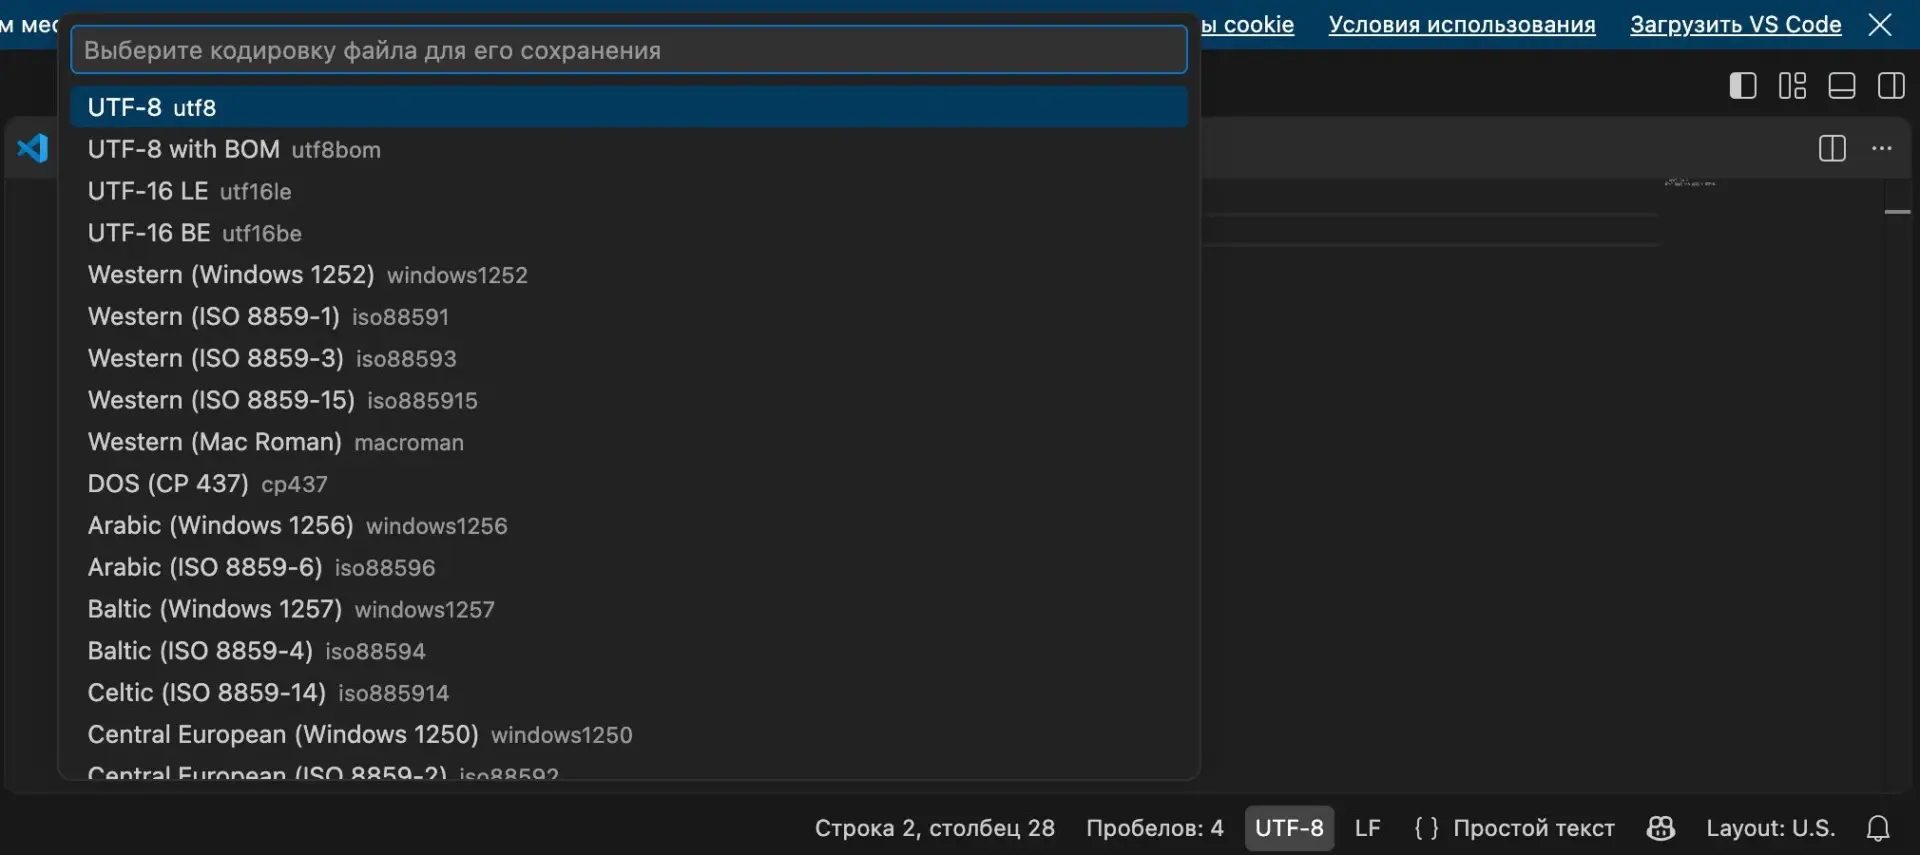
Обратите внимание на два верхних пункта: UTF-8 и UTF-8 with BOM. Для кода и сайтов берите UTF-8 без BOM. Как создать в редакторе первый файл, показано в инструкции про файл Python в VS Code.
Блокнот Windows
Со сборки Windows 10 под номером 18298 Блокнот по умолчанию сохраняет новые файлы в UTF-8 без BOM и показывает кодировку в строке состояния. Старый файл переводится в UTF-8 через «Файл» → «Сохранить как»: внизу окна есть список кодировок.
Остальные приёмы Блокнота собраны в статье о Блокноте Windows.
Excel и CSV
В справке Microsoft сказано: CSV в UTF-8 открывается обычным способом, если он сохранён с BOM. Файл без BOM справка предлагает открыть через импорт:
- Откройте вкладку «Данные».
- Выберите «Получение данных» → «Из файла» → «Получение данных из текстового или CSV-файла».
- Укажите файл и посмотрите на предпросмотр: если кириллица в нём читается, кодировка определена верно.
Как устроен сам формат и как прочитать его кодом, разобрано в статье о формате CSV.
UTF-8 в коде: HTML, Python и JavaScript
HTML
Кодировку страницы объявляет тег meta в начале head:
<meta charset="utf-8">По справке MDN, в HTML5 допустимо только значение utf-8, а сам тег должен целиком уместиться в первые 1024 байта документа. Поэтому его ставят первой строкой внутри head, как в шаблоне из инструкции о создании HTML-файла.
Python
Строка в Python хранит символы, байты появляются только при кодировании. Поэтому len() строки и её байтов расходятся: в примере выше у «Привет» 6 символов и 12 байт.
С файлами указывайте кодировку явно:
with open("data.txt", "w", encoding="utf-8") as f:
    f.write("Привет, мир!")

with open("data.txt", encoding="utf-8") as f:
    print(f.read())
Привет, мир!По документации функции open(), с версии 3.15 Python и так берёт UTF-8 по умолчанию. В более старых версиях без encoding берётся кодировка системы, а на русской Windows это обычно cp1251. Файл, записанный на Linux, тогда читается с кракозябрами. О чтении и записи файлов подробно рассказано в статье как открыть файл в Python.
CheckroiПодборка курсов по Python466 курсов • 48 школСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
JavaScript
Строки в JavaScript хранятся в UTF-16. Поэтому свойство length считает 16-битные единицы, а не символы, о чём предупреждает MDN. Байты UTF-8 считает TextEncoder:
const enc = new TextEncoder();
console.log("Ж".length, enc.encode("Ж").length);
console.log("😀".length, enc.encode("😀").length, [..."😀"].length);
1 2
2 4 1У эмодзи length равен 2, в UTF-8 у него 4 байта, а запись [..."😀"] делит строку по кодовым точкам и даёт один символ. Это стоит помнить, когда проверяете длину поля в форме.
 Канал основателя Checkroi Вани БуявцаЗабирайте промпты и обучение по нейросетям в моём Телеграм-каналеБольше 3 700 человек уже применяют Claude Code, ChatGPT и другие нейросети в работе, учёбе, бизнесе и жизниПерейти в канал
Частые ошибки с UTF-8
Невидимый символ в начале файла
Байты EF BB BF в начале файла называются BOM, метка порядка байтов. По спецификации UTF-8, в этой кодировке она всегда выглядит именно так. Из-за неё первая колонка CSV в скрипте называется не id, а \ufeffid.
Решение: сохранять файлы для кода без BOM, а чужой файл с BOM читать с кодировкой utf-8-sig:
with open("table.csv", encoding="utf-8") as f:
    print(repr(f.readline()))

with open("table.csv", encoding="utf-8-sig") as f:
    print(repr(f.readline()))
'\ufeffid;name\n'
'id;name\n'Обрезка строки ломает букву
Если резать уже закодированные байты, можно разорвать русскую букву пополам. Первые три байта слова «Привет» дают «П» и половину «р»:
data = "Привет".encode("utf-8")
print(data[:3].decode("utf-8", errors="replace"))П�Решение: обрезать строку до кодирования, по символам. Нужные методы собраны в шпаргалке по строкам Python.
Эмодзи не сохраняются в MySQL
В MySQL имя utf8 исторически означает utf8mb3, и это устаревший псевдоним. В utf8mb3 не больше 3 байт на символ, а эмодзи нужно 4, поэтому их такая колонка не хранит вовсе.
CheckroiПодборка курсов по MySQL71 курс • 17 школСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Решение: для новых таблиц ставить utf8mb4, документация MySQL рекомендует его всем новым приложениям. Основы запросов собраны в статье о команде SELECT в MySQL.
Одинаковые слова не равны
Букву «é» можно записать одной кодовой точкой или двумя: «e» плюс знак ударения. На экране они неотличимы, а сравнение говорит, что строки разные:
import unicodedata

a = "é"
b = "e\u0301"
print(a == b, len(a), len(b))
print(unicodedata.normalize("NFC", b) == a)
False 1 2
TrueРешение: перед сравнением и поиском приводить строки к одной форме через unicodedata.normalize(). В Unicode HOWTO этому посвящён отдельный раздел о сравнении строк.
Где освоить программирование системно
С кодировками сталкивается каждый, кто пишет код: парсит CSV, отдаёт JSON, сохраняет форму в базу. Одну ошибку можно закрыть по инструкции, а чтобы понимать, как устроены строки и байты, нужен курс с практикой и проверкой кода.
Ниже курсы по JavaScript из нашего каталога. О самой профессии рассказывает статья о JavaScript-разработчике, а подборки по смежным темам лежат в разделах курсы Python и курсы веб-разработки.
| Курс | Школа | Стоимость со скидкой | В рассрочку | Длительность | Обзор курса от Checkroi |
|---|---|---|---|---|---|
| JavaScript Перейти на сайт курса | Skillbox | 65 744 ₽ | 4086 ₽/мес. | 3 месяца | Обзор курса |
| Fullstack разработчик JavaScript Перейти на сайт курса | OTUS | 75 000 ₽ | 20 000 ₽/мес. | 6 месяцев | Обзор курса |
| Факультет fullstack JavaScript Перейти на сайт курса | GeekBrains | 134 700 ₽ | 3742 ₽/мес. | 15 месяцев | Обзор курса |
| Fullstack-разработчик на JavaScript Перейти на сайт курса | Эдюсон | 158 760 ₽ | 6615 ₽/мес. | 11 месяцев | Обзор курса |
| Фулстек-разработчик на JavaScript Перейти на сайт курса | Skillbox | 157 948 ₽ | 4296 ₽/мес. | 11 месяцев | Обзор курса |
Больше программ — в полном каталоге курсов по Javascript