

HTTP, или протокол передачи гипертекста (HyperText Transfer Protocol), это набор правил, по которым браузер или другая программа просит у сервера страницу, картинку или данные, а сервер отвечает. Клиент отправляет текстовый запрос: что сделать, с каким адресом и какие у него условия. Сервер возвращает код результата, заголовки и само содержимое.
Ниже разберём живой запрос и ответ построчно, покажем, как отправить запрос самому, и сравним версии от HTTP/0.9 до HTTP/3. Если хочется сначала понять, где HTTP стоит среди других протоколов, загляните в обзор сетевых протоколов.
 CheckroiПодборка курсов по Backend-разработке129 курсов • 26 школСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Что такое HTTP простыми словами
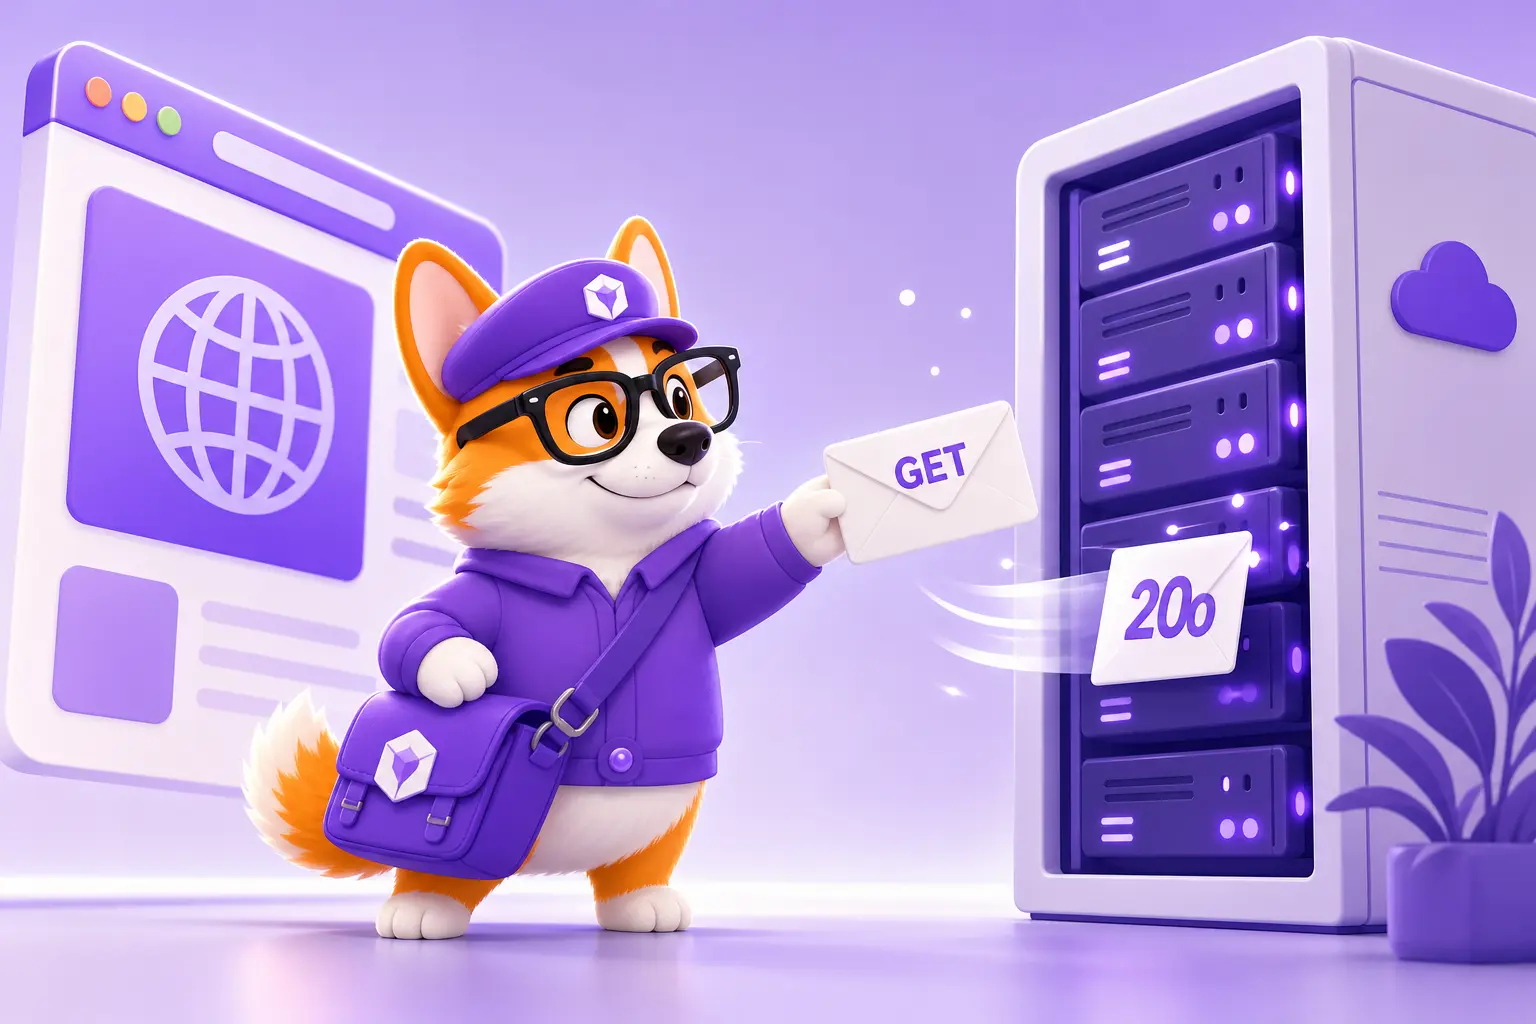
HTTP описывает разговор двух сторон. Одна спрашивает, другая отвечает, и обе заранее знают формат реплик. Так браузер и сервер понимают друг друга, даже если их написали разные люди на разных языках.
- Клиент отправляет запрос. Это может быть браузер, мобильное приложение, скрипт на Python или утилита curl.
- Сервер принимает запрос и решает, что ответить. Это nginx, Apache, приложение на Django или Node.js. Такие приложения пишут backend-разработчики, им учат на курсах backend-разработки.
- Посредники: прокси, CDN и балансировщики. Они стоят между клиентом и сервером, могут кешировать ответы и раздавать запросы по нескольким машинам.
Протокол работает на прикладном уровне. Под ним лежит транспорт: для HTTP/1.1 и HTTP/2 это TCP, для HTTP/3 протокол QUIC поверх UDP (про разницу транспортов есть отдельный разбор протокола UDP). Если порт в адресе не указан, по RFC 9110 для http берётся TCP-порт 80, для https 443.
Вместе с HTML и адресами URL протокол HTTP придумал Тим Бернерс-Ли, когда собирал всемирную паутину. Отсюда и «гипертекст» в названии: сначала по HTTP передавали только связанные ссылками документы. Сейчас по нему ходят JSON для мобильных приложений, видео, файлы и запросы к API.
HTTP не помнит, кто вы
Главное свойство протокола в том, что у него нет состояния. В RFC 9110 это сформулировано так: смысл каждого запроса понятен сам по себе, без связи с предыдущими.
Там же сказано, что сервер не должен считать два запроса из одного соединения запросами одного клиента, если соединение не защищено и не закреплено за ним. Поэтому сам протокол не запоминает, что вы вошли в личный кабинет.
Решение: память добавляют поверх протокола. Сервер присылает заголовок Set-Cookie, браузер возвращает его в заголовке Cookie с каждым следующим запросом. Оба заголовка описаны в RFC 6265. Так работают корзины в магазинах и «запомнить меня» на сайтах.
Чем HTTP отличается от HTTPS
HTTPS устроен как тот же HTTP, только поверх шифрованного соединения TLS. Методы, заголовки и коды те же, а посторонний в сети видит лишь зашифрованный поток. Порт по умолчанию 443 вместо 80.
Обычный HTTP передаёт всё открытым текстом: пароль из формы входа может прочитать любой, кто стоит на пути трафика, например владелец публичного Wi-Fi. Поэтому браузеры помечают такие сайты как незащищённые. Как устроено рукопожатие TLS и как перевести сайт на HTTPS, мы разобрали в статье HTTP и HTTPS: в чём разница.
Как проходит один HTTP-запрос
Вы набрали адрес и нажали Enter. До того как на экране появится страница, браузер проходит несколько шагов:
- Узнаёт IP-адрес сервера. Имя домена превращается в адрес через DNS, а ответ DNS какое-то время хранится в кеше (сколько именно, задаёт TTL).
- Открывает соединение. Для HTTP/1.1 и HTTP/2 это TCP-соединение, по сути сокет между двумя программами. Для https сверху ещё идёт рукопожатие TLS.
- Отправляет запрос. Метод, путь, версия протокола, заголовки и, если нужно, тело.
- Получает ответ. Код состояния, заголовки и содержимое, например HTML страницы.
- Дозапрашивает остальное. Читая HTML, браузер находит стили, скрипты и картинки и за каждым файлом отправляет отдельный запрос.
Одна страница легко порождает десятки запросов. Поэтому скорость сайта так сильно зависит от версии протокола, и к этому мы вернёмся в разделе про версии.
Канал основателя Checkroi Вани Буявца3 700 человек читают мой Телеграм-канал про нейросетиСобрал промпты для Claude Code и ChatGPT, разборы ИИ-инструментов и лайфхаки по продвижению бизнеса в одном местеПрисоединитьсяИз чего состоит HTTP-запрос
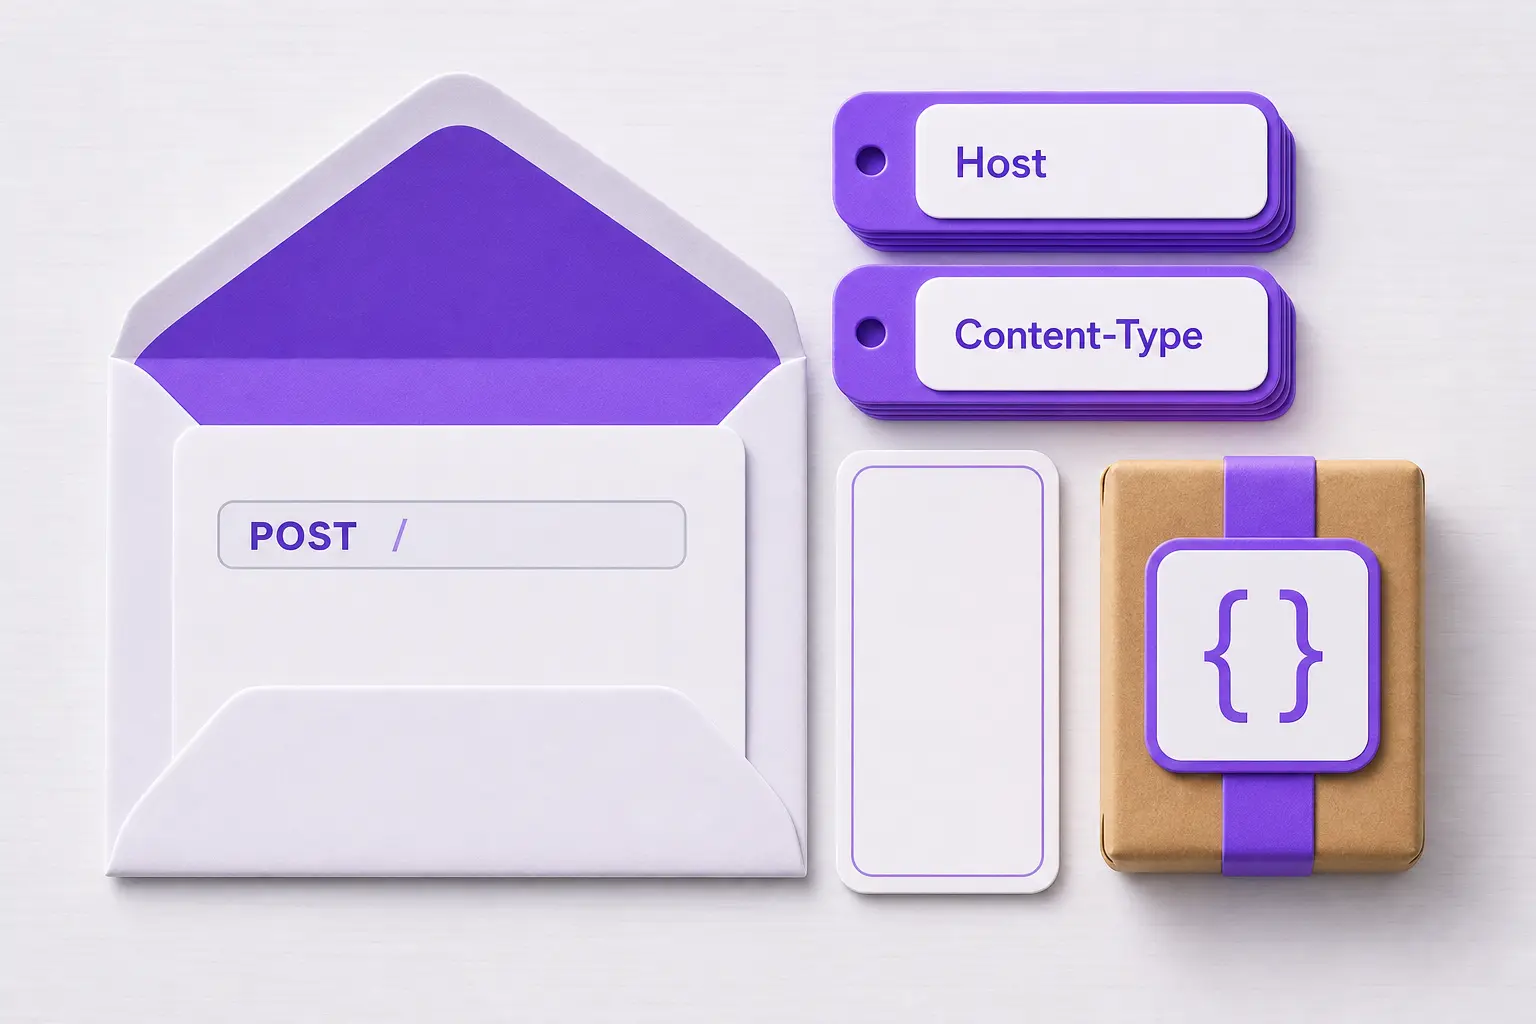
Лучше всего структура видна на настоящем запросе. Мы отправили его утилитой curl с ключом -v: строки со знаком > ушли на сервер, со знаком < пришли обратно.
$ curl -v -X POST -H 'Content-Type: application/json' -d '{"name":"Анна"}' http://example.com/

> POST / HTTP/1.1
> Host: example.com
> User-Agent: curl/8.7.1
> Accept: */*
> Content-Type: application/json
> Content-Length: 19
>
< HTTP/1.1 405 Method Not Allowed
< Content-Type: text/html
< Transfer-Encoding: chunked
< Connection: keep-alive
< Server: cloudflare
Вывод сокращён: из ответа убраны служебные заголовки Cloudflare. В запросе четыре части, и у каждой своя роль.
| Часть | Пример из запроса | Что означает |
|---|---|---|
| Стартовая строка | POST / HTTP/1.1 |
метод, путь к ресурсу и версия протокола |
| Заголовки | Host: example.com |
условия запроса: для какого сайта, в каком формате данные, какой клиент |
| Пустая строка | строка с одним > |
граница: заголовки кончились, дальше тело |
| Тело | {"name":"Анна"} |
данные для сервера; у GET-запроса его обычно нет |
Стартовая строка
Первое слово называют методом: оно говорит, что клиент хочет сделать. GET просит отдать ресурс, POST отправляет данные, DELETE просит удалить. Подробная шпаргалка по всем методам и разница между GET и POST есть в статье о методах HTTP.
Дальше идёт путь (/ означает главную страницу), а в конце версия протокола. В пути может быть строка параметров после знака вопроса: /search?q=http&page=2.
Заголовки
Каждый заголовок записан парой «имя: значение» на отдельной строке. Имена не зависят от регистра, это прямо сказано в RFC 9110, поэтому Content-Type и content-type для сервера одно и то же.
Один заголовок в HTTP/1.1 обязателен, это Host. На одном IP-адресе часто живут сотни сайтов, и только по этому заголовку сервер понимает, к какому из них пришли. По RFC 9112 запрос HTTP/1.1 без Host сервер должен отклонить с кодом 400 Bad Request.
Тело запроса
Тело несёт данные: JSON, поля формы, загружаемый файл. Формат тела указывает Content-Type, размер указывает Content-Length.
Обратите внимание на
Content-Length: 19. Строка{"name":"Анна"}состоит из 15 символов, но длина считается в байтах: каждая русская буква в UTF-8 занимает два байта, поэтому «Анна» весит 8 байт, а всё тело 19 байт.
Из чего состоит HTTP-ответ
Ответ устроен так же, как запрос: стартовая строка, заголовки, пустая строка, тело. Отличается только первая строка, её называют строкой состояния.
В нашем примере это HTTP/1.1 405 Method Not Allowed. Сервер example.com отдаёт главную страницу только на GET и HEAD (это видно по его заголовку Allow: GET, HEAD в ответе на обычный GET), поэтому на POST вернул ошибку. Строка состояния включает три элемента:
- версию протокола:
HTTP/1.1; - код состояния, трёхзначное число
405, его читают программы; - текстовое пояснение
Method Not Allowed, его читают люди.
Коды делятся на пять классов по первой цифре. Классы и их смысл заданы в RFC 9110:
| Класс | Что значит | Частые коды |
|---|---|---|
| 1xx | информационный: запрос получен, обработка продолжается | 100, 101 |
| 2xx | успех: запрос получен, понят и принят | 200, 201, 204 |
| 3xx | перенаправление: нужно действие, чтобы завершить запрос | 301, 302, 304 |
| 4xx | ошибка клиента: в запросе ошибка или его нельзя выполнить | 400, 403, 404, 405 |
| 5xx | ошибка сервера: запрос корректный, но сервер не справился | 500, 502, 503 |
Какие заголовки приходят в ответе
У ответа свои заголовки, и по ним браузер решает, что делать с содержимым. Чаще всего в ответе встречаются четыре:
Content-Typeговорит, что лежит в теле:text/html,application/json, картинка. Без него браузер гадает, показывать страницу или скачивать файл.Cache-Controlзадаёт, можно ли сохранить ответ в кеше и на сколько секунд.Set-Cookieпросит браузер запомнить cookie и присылать её дальше.Locationприходит вместе с кодами 3xx и указывает новый адрес.
Последний легко увидеть самому. Мы запросили GitHub по старому адресу без шифрования, и сервер сразу отправил на защищённую версию:
$ curl -sI http://github.com/
HTTP/1.1 301 Moved Permanently
Location: https://github.com/
Браузер в такой ситуации сам открывает адрес из Location, и пользователь редиректа даже не замечает. Вывод сокращён до двух строк, остальные заголовки ответа здесь не важны.
Разбор каждого кода и способы проверить ответ своего сайта собраны в инструкции про коды ответов сервера.
Как отправить HTTP-запрос самому
HTTP/1.1 передаёт сообщения обычным текстом. Запрос можно набрать руками и отправить через сетевое соединение, без браузера и библиотек. Вот такой скрипт на Python мы запустили, чтобы это показать:
import socket

request = (
    "GET / HTTP/1.1\r\n"
    "Host: example.com\r\n"
    "Connection: close\r\n"
    "\r\n"
)

with socket.create_connection(("example.com", 80)) as sock:
    sock.sendall(request.encode("ascii"))
    response = b""
    while chunk := sock.recv(4096):
        response += chunk

head, _, body = response.partition(b"\r\n\r\n")
print(head.decode("ascii").splitlines()[0])
print("Строк заголовков:", len(head.splitlines()) - 1)
print("Тело начинается так:", body[:15])
Вывод:
HTTP/1.1 200 OK
Строк заголовков: 12
Тело начинается так: b'241\r\n<!doctype '
Каждая строка запроса заканчивается парой символов \r\n, а пустая строка \r\n в конце говорит серверу, что заголовки кончились. Без неё сервер будет ждать продолжения.
Число 241 перед HTML появилось не случайно. Сервер ответил с заголовком Transfer-Encoding: chunked и отдаёт тело кусками, перед каждым пишет его длину в шестнадцатеричной записи. Шестнадцатеричное 241 в привычной десятичной записи равно 577 байтам. Такая передача кусками описана в RFC 9112 и нужна, когда сервер ещё не знает, какого размера получится ответ.
В повседневной работе сокеты руками не пишут. Хватает трёх инструментов:
- curl в терминале:
curl -v https://example.com/покажет запрос и ответ целиком, а примеры POST с JSON через curl есть в разборе GET и POST; - библиотека requests в Python:
requests.get(url)соберёт запрос сама; - инструменты разработчика в браузере (клавиша F12): там видны все запросы страницы с заголовками и временем загрузки.
Версии HTTP: от 0.9 до HTTP/3
Смысл протокола за 35 лет почти не изменился: те же методы, коды и заголовки. Менялось то, как эти сообщения упаковываются и передаются по сети.
| Версия | Когда и где описана | Что появилось |
|---|---|---|
| HTTP/0.9 | 1991, документ W3C | одна строка GET /адрес, в ответ только HTML; ни заголовков, ни кодов |
| HTTP/1.0 | май 1996, RFC 1945 | версия в стартовой строке, заголовки, коды состояния, любые типы файлов |
| HTTP/1.1 | январь 1997 (RFC 2068), сейчас RFC 9112 от июня 2022 | обязательный Host, постоянные соединения, передача кусками |
| HTTP/2 | май 2015 (RFC 7540), сейчас RFC 9113 от июня 2022 | бинарные кадры, много запросов в одном соединении, сжатие заголовков |
| HTTP/3 | июнь 2022, RFC 9114 | транспорт QUIC вместо TCP, TLS 1.3 встроен в транспорт |
Почему HTTP/1.1 стало мало
В HTTP/1.1 нет мультиплексирования: по одному соединению запросы идут друг за другом. Чтобы грузить файлы параллельно, браузеры открывают несколько TCP-соединений к одному сайту. В RFC 9114 отмечено, что это плохо сказывается на управлении перегрузкой и эффективности сети.
HTTP/2 решил это бинарными кадрами: много запросов идут параллельно в одном соединении. Но под ним по-прежнему TCP, и если потерялся один пакет, по тому же RFC встают все активные запросы соединения, даже не связанные с потерянным пакетом.
Решение: HTTP/3 переехал на QUIC. Этот транспорт сам ведёт отдельные потоки, и потеря пакета задерживает только свой поток. Ещё QUIC шифрует трафик через TLS 1.3 прямо на транспортном уровне.
Какая версия сейчас основная
По подсчёту W3Techs на 25 октября 2026 года, HTTP/3 используют 41,1 % сайтов, а HTTP/2 35,0 %. HTTP/1.1 никуда не делся: его до сих пор понимает любой сервер, и именно его показывают в учебных примерах.
Как узнать, по какой версии отвечает сайт
Проще всего через curl с форматом вывода. Мы проверили example.com с ключом --http1.1 и без него:
$ curl -s -o /dev/null -w '%{http_version} %{http_code}\n' --http1.1 https://example.com/
1.1 200
$ curl -s -o /dev/null -w '%{http_version} %{http_code}\n' https://example.com/
2 200
Без ключа curl договорился с сервером о HTTP/2. А вот так выглядит начало ответа HTTP/2:
$ curl -sI --http2 https://example.com/
HTTP/2 200
date: Sun, 25 Oct 2026 04:17:07 GMT
content-type: text/html; charset=utf-8
server: cloudflare
alt-svc: h3=":443"; ma=86400
Здесь видны три отличия от HTTP/1.1:
- после кода 200 нет слов
OK: в HTTP/2 ответ несёт только код в служебном поле:status(RFC 9113); - имена заголовков написаны строчными буквами: по тому же RFC при сборке сообщения HTTP/2 их обязательно переводят в нижний регистр;
- заголовок
alt-svc: h3=":443"сообщает, что этот сайт доступен и по HTTP/3. ЧерезAlt-Svcсервер объявляет HTTP/3 по RFC 9114, и следующие запросы браузер может отправить уже через QUIC.
 Канал основателя Checkroi Вани БуявцаЗабирайте промпты и обучение по нейросетям в моём Телеграм-каналеБольше 3 700 человек уже применяют Claude Code, ChatGPT и другие нейросети в работе, учёбе, бизнесе и жизниПерейти в канал
Частые ошибки и заблуждения
- «HTTP является языком программирования». Нет, это протокол, то есть договорённость о формате сообщений. Языки (Python, JavaScript, Go) только отправляют и принимают HTTP-запросы через свои библиотеки.
- «Content-Length считается в символах». В байтах. Отсюда ошибки у тех, кто собирает запрос руками: кириллица в UTF-8 весит вдвое больше латиницы, и сервер обрезает тело.
- «Сервер помнит, что я уже вошёл». Сам протокол ничего не помнит. Вход хранится в cookie или токене, который клиент отправляет с каждым запросом заново.
- «Ответ HTTP/2 200 без OK сломан». Всё в порядке: текстового пояснения в HTTP/2 просто нет, программы ориентируются на код.
- «POST безопаснее GET, потому что данные не видно». Тело POST не попадает в адресную строку, но без HTTPS его так же легко перехватить. От перехвата защищает только шифрование. Как методы ведут себя при повторных запросах, разобрано в статье про идемпотентность.
Где освоить HTTP и веб-разработку системно
Чтобы разобраться в запросах и ответах, хватит curl и вечера. А вот проектировать API, настраивать серверы и отлаживать медленный сайт учат на курсах веб- и backend-разработки, где HTTP проходят на практике, вместе с базами данных и фреймворками. Если думаете о профессии, начните с карты пути в статье как стать backend-разработчиком.
Ниже собраны курсы по веб-разработке из нашего каталога, их можно сравнить по цене, длительности и формату.
| Курс | Школа | Стоимость со скидкой | В рассрочку | Длительность | Обзор курса от Checkroi |
|---|---|---|---|---|---|
| Профессия «Fullstack-разработчик на PHP» Перейти на сайт курса |  Skillbox | 166 715 ₽ | 5378 ₽/мес. | 12 месяцев | Обзор курса |
| Fullstack-разработчик на Python Перейти на сайт курса |  Нетология | 137 000 ₽ | 7125 ₽/мес. | 21 месяц | Обзор курса |
| Профессия «Веб-разработчик с нуля» Перейти на сайт курса | Нетология | 127 300 ₽ | 7125 ₽/мес. | 13 месяцев | Обзор курса |
| Профессия «Fullstack-разработчик» Перейти на сайт курса | Skillbox | 149 738 ₽ | 4404 ₽/мес. | 10 месяцев | Обзор курса |
| Веб-разработчик Перейти на сайт курса |  Академия Синергия | 141 036 ₽ | 5877 ₽/мес. | 6 месяцев | Обзор курса |
Больше программ — в полном каталоге курсов по веб-разработке