Случайный лес (random forest) — это алгоритм машинного обучения, который строит сотни деревьев решений и объединяет их ответы. Каждое дерево учится на своей случайной выборке строк и на каждом разбиении смотрит только на часть признаков. В классификации деревья голосуют за класс, в регрессии их прогнозы усредняются.
Одно дерево легко подстраивается под шум в данных, а ансамбль из сотни разных деревьев ошибается заметно реже. Поэтому на табличных данных лес удобно пробовать одним из первых. Где он стоит среди других алгоритмов, разобрано в обзоре моделей машинного обучения.
Ниже: как устроен алгоритм, рабочий код на Python с реальным выводом, какие гиперпараметры трогать и где лес проигрывает простой линейной модели.
 Рекомендуем курсы по машинному обучению
 SkillboxMachine Learning с нуля до Junior123 543 ₽9 месяцев
 НетологияМашинное обучение43 600 ₽10 месяцев
 OTUSMachine Learning. Продвинутый уровень65 000 ₽5 месяцев
 SkillFactoryОнлайн-магистратура МИФИ "Машинное обучение"230 000 ₽ /семестр24 месяца
 TeachMeSkillsMachine learning130 000 ₽8 месяцев
 GeekBrainsДО Профессия Machine Learning Engineer151 725 ₽3 месяца
Что такое случайный лес простыми словами
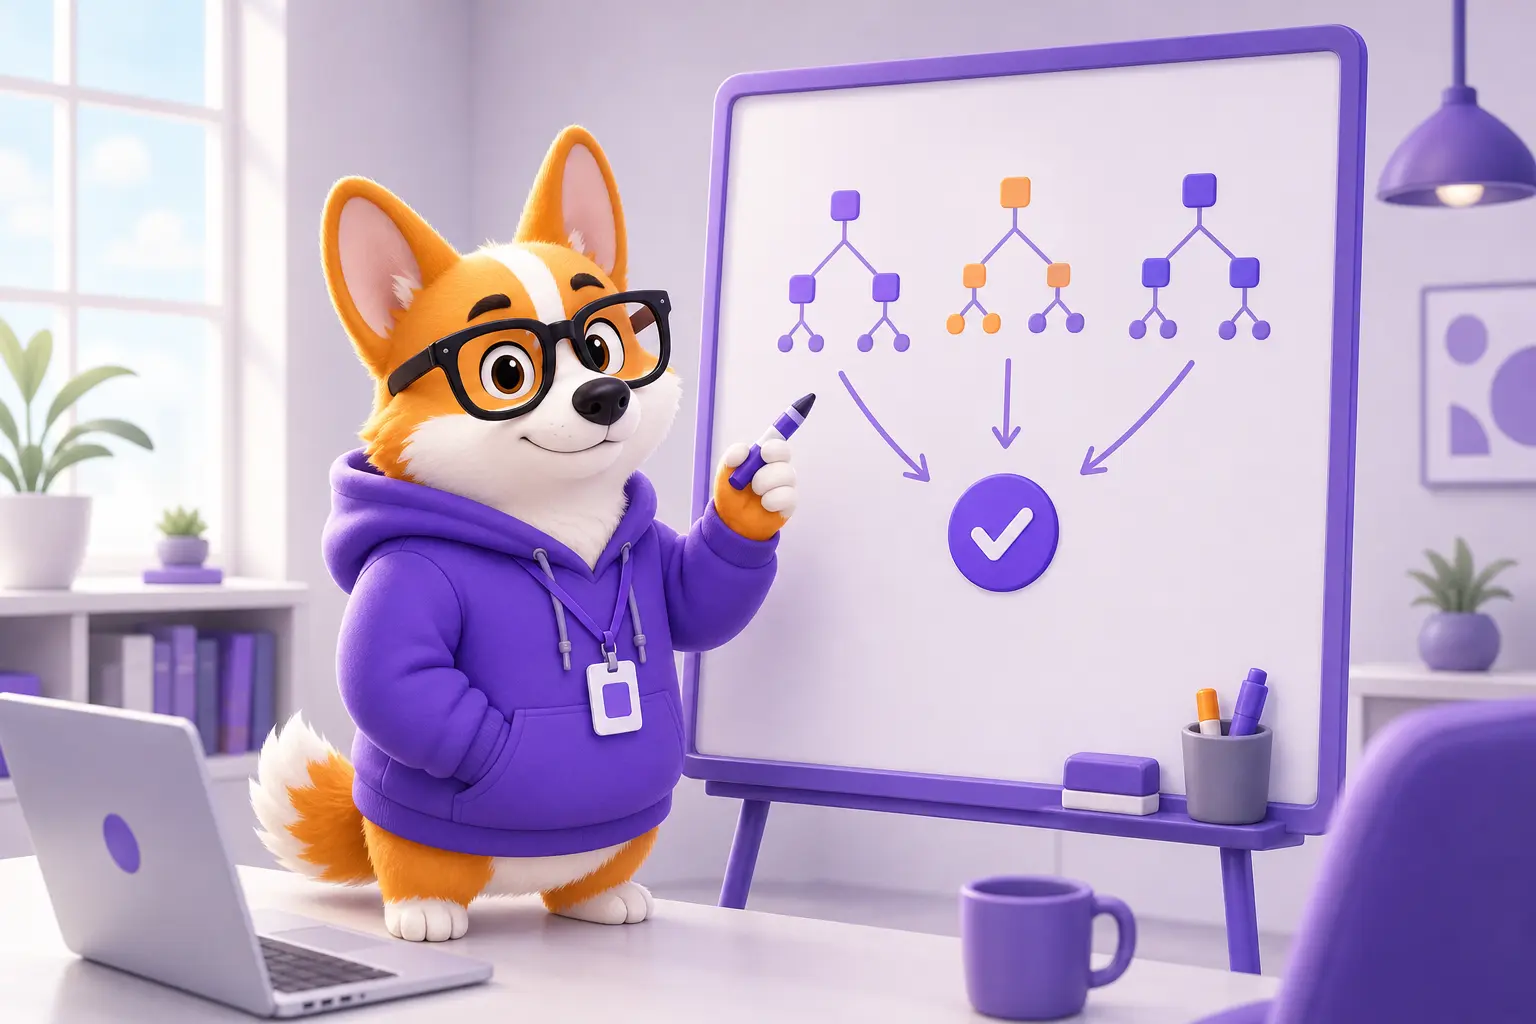
Представьте консилиум из ста врачей. Каждый видел только часть историй болезни и обращал внимание на разные анализы. По отдельности они ошибаются, но если собрать их мнения и взять большинство, диагноз выходит точнее, чем у любого из них.
Случайный лес работает так же, только вместо врачей у него деревья решений. Метод описал статистик Лео Брейман в статье Random Forests, опубликованной в 2001 году в журнале Machine Learning. В его определении лес — набор деревьев-классификаторов, где каждое дерево отдаёт один голос за самый популярный класс.
Алгоритм решает два типа задач:
- классификацию — отнести объект к классу: спам или нет, уйдёт клиент или останется, опухоль доброкачественная или злокачественная;
- регрессию — предсказать число: цену квартиры, спрос на товар, время доставки. Что это за задача, подробно рассказано в статье про регрессию в анализе данных.
Слово «случайный» в названии про то, как деревья становятся непохожими друг на друга. Без этой случайности все сто деревьев выросли бы одинаковыми и ошибались бы одинаково.
Как работает алгоритм: четыре шага
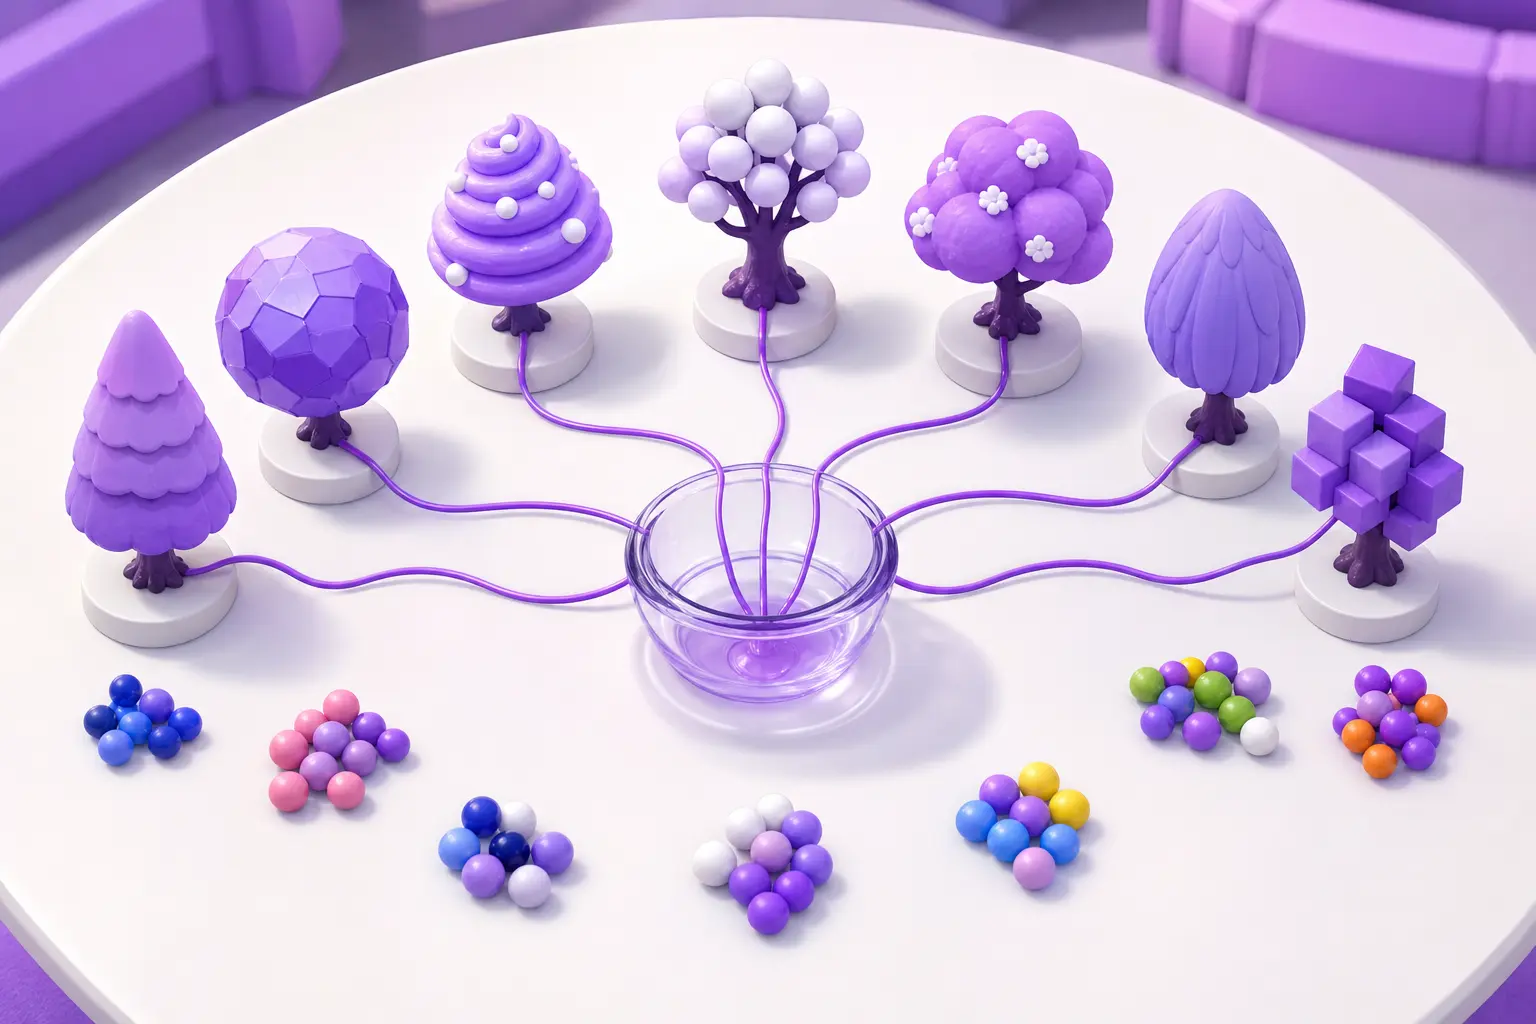
У случайного леса два источника случайности: выборка строк и выборка признаков. Вот полный цикл.
- Бутстрэп-выборка. Для каждого дерева из обучающих данных случайно, с возвращением, выбирают столько же строк, сколько было в исходном наборе. Одни строки попадают несколько раз, другие не попадают вовсе. По оценке Бреймана, в каждую такую выборку не входит около трети объектов.
- Случайные признаки на каждом разбиении. Дерево растёт как обычно, но в каждом узле выбирает лучшее разбиение не из всех признаков, а из случайного подмножества. В классификации в scikit-learn по умолчанию берут корень из числа признаков: из 30 признаков на каждом шаге смотрят на 5.
- Повтор. Шаги 1 и 2 повторяют для каждого дерева. Деревья не зависят друг от друга, поэтому их можно строить параллельно на всех ядрах процессора.
- Объединение ответов. В регрессии прогнозы деревьев усредняют. В классификации у Бреймана деревья голосуют, а scikit-learn вместо голосования усредняет вероятности классов и берёт класс с наибольшей.
Коротко, где в алгоритме случайность и зачем она нужна:
| Что случайно | Как | Что даёт |
|---|---|---|
| Строки для дерева | бутстрэп, выборка с возвращением | деревья учатся на разных данных, а пропущенные строки служат проверкой |
| Признаки в узле | случайное подмножество размером max_features |
сильный признак не забирает себе верх каждого дерева, деревья меньше похожи друг на друга |
Почему сто деревьев точнее одного
Глубокое дерево решений запоминает обучающие данные вместе с шумом. На новых данных оно ошибается, и ошибки сильно зависят от того, какие строки попали в обучение. Это переобучение.
Если деревья ошибаются по-разному, при усреднении их ошибки частично гасят друг друга. Брейман в статье показывает, что точность леса зависит от двух вещей: насколько сильны отдельные деревья и насколько они коррелируют между собой. Случайные признаки как раз снижают корреляцию.
Канал основателя Checkroi Вани Буявца3 800 человек читают мой Телеграм-канал про нейросетиСобрал промпты для Claude Code и ChatGPT, разборы ИИ-инструментов и лайфхаки по продвижению бизнеса в одном местеПрисоединитьсяОтсюда главное свойство: добавление деревьев не ведёт к переобучению. Ошибка леса с ростом числа деревьев сходится к пределу, это Брейман доказывает через закон больших чисел.
Пример на Python: лес против одного дерева
Возьмём встроенный в scikit-learn датасет о раке молочной железы: 569 пациенток, 30 числовых признаков опухоли, два класса. Что такое датасет и откуда их берут, рассказано в отдельной статье про датасеты.
Код запускается в Jupyter Notebook или в браузере через Google Colab, где scikit-learn уже установлен. Локально хватит pip install scikit-learn pandas. Если с библиотекой вы ещё не работали, загляните в подборку курсов по scikit-learn.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y
)

tree = DecisionTreeClassifier(random_state=42).fit(X_train, y_train)
forest = RandomForestClassifier(
    n_estimators=300, oob_score=True, n_jobs=-1, random_state=42
).fit(X_train, y_train)

print("Объектов в обучении:", len(X_train), "признаков:", X.shape[1])
print("Одно дерево, точность на тесте:", round(accuracy_score(y_test, tree.predict(X_test)), 3))
print("Случайный лес, точность на тесте:", round(accuracy_score(y_test, forest.predict(X_test)), 3))
print("Out-of-bag оценка леса:", round(forest.oob_score_, 3))
Вывод в scikit-learn 1.9.1:
Объектов в обучении: 426 признаков: 30
Одно дерево, точность на тесте: 0.923
Случайный лес, точность на тесте: 0.958
Out-of-bag оценка леса: 0.962
На 143 тестовых пациентках дерево ошиблось 11 раз, лес — 6. Ни одного параметра, кроме числа деревьев, не настраивали.
Интерфейс у леса тот же, что у любой модели scikit-learn: fit, predict, predict_proba. Если вы уже обучали логистическую регрессию в Python, менять придётся одну строку.
CheckroiПодборка курсов по Scikit-learn40 курсов • 11 школСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Out-of-bag: проверка без отложенной выборки
Помните треть строк, которые не попали в бутстрэп-выборку дерева? Для каждой строки можно собрать прогнозы только тех деревьев, которые её не видели, и сравнить с правильным ответом. Это out-of-bag оценка (OOB), в scikit-learn она включается параметром oob_score=True.
Брейман ссылается на эксперименты, по которым OOB-оценка так же точна, как тестовая выборка того же размера, что и обучающая. Он же предупреждает, что оценка завышает ошибку, потому что каждую строку проверяет только около трети деревьев.
В примере выше OOB дала 0,962, а тест 0,958. Цифры близкие, но для итогового отчёта по модели отложенная выборка всё равно надёжнее.
Гиперпараметры, которые стоит знать
У RandomForestClassifier и RandomForestRegressor больше 15 параметров, но на практике трогают пять-шесть. Значения по умолчанию взяты из scikit-learn 1.9.1, полный список есть в документации RandomForestClassifier.
| Параметр | По умолчанию | Что делает | Когда менять |
|---|---|---|---|
n_estimators |
100 | число деревьев | увеличить, пока растёт OOB-точность |
max_features |
"sqrt" в классификации, 1.0 в регрессии |
сколько признаков смотреть в каждом узле | главный рычаг разнообразия деревьев, подбирать первым |
max_depth |
None |
предельная глубина дерева | ограничить, если модель весит слишком много |
min_samples_leaf |
1 | минимум объектов в листе | поднять до 3–10 на шумных данных |
class_weight |
None |
веса классов | "balanced", если один класс встречается редко |
n_jobs |
None |
сколько ядер занять | -1 занимает все ядра и ускоряет обучение |
В руководстве scikit-learn по ансамблям сказано, что хорошие результаты часто даёт связка max_depth=None и min_samples_split=2, то есть полностью выращенные деревья. Там же оговорка: такие значения обычно не оптимальны и могут занять много памяти.
Это заметно даже на маленьком датасете. Лес из 300 деревьев из примера выше весит около 890 КБ в pickle, одно дерево — 4 КБ.
Сколько деревьев нужно
Документация scikit-learn формулирует так: чем больше деревьев, тем лучше, но тем дольше считать, и после некоторого числа результаты перестают заметно улучшаться. Проверить это на своих данных можно циклом по OOB-оценке:
from sklearn.datasets import load_breast_cancer
from sklearn.ensemble import RandomForestClassifier

X, y = load_breast_cancer(return_X_y=True)
for n in [10, 25, 50, 100, 300, 600]:
    forest = RandomForestClassifier(n_estimators=n, oob_score=True, n_jobs=-1, random_state=42)
    forest.fit(X, y)
    print(f"деревьев {n:>3}: OOB-точность {forest.oob_score_:.3f}")
деревьев 10: OOB-точность 0.931
деревьев 25: OOB-точность 0.953
деревьев 50: OOB-точность 0.961
деревьев 100: OOB-точность 0.961
деревьев 300: OOB-точность 0.961
деревьев 600: OOB-точность 0.961На этом датасете точность выходит на плато уже к 50 деревьям. При 10 деревьях scikit-learn ещё и предупреждает UserWarning: Some inputs do not have OOB scores: некоторые строки попали в выборку каждого дерева, и проверить их нечем.
Решение: начинайте со 100–300 деревьев и смотрите на кривую, а не на круглое число.
CheckroiПодборка курсов по машинному обучению149 курсов • 29 школСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Регрессия: где лес проигрывает линейной модели
Лес даёт приличный результат почти без настройки, но выигрывает он не всегда. Возьмём встроенный датасет о диабете: 442 пациента, 10 признаков, цель — показатель прогрессирования болезни через год.
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_absolute_error

X, y = load_diabetes(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)

for name, model in [
    ("Линейная регрессия", LinearRegression()),
    ("Лес, все признаки (по умолчанию)", RandomForestRegressor(n_estimators=300, random_state=42, n_jobs=-1)),
    ("Лес, треть признаков", RandomForestRegressor(n_estimators=300, max_features=1/3, min_samples_leaf=5, random_state=42, n_jobs=-1)),
]:
    model.fit(X_train, y_train)
    print(f"{name}: MAE = {mean_absolute_error(y_test, model.predict(X_test)):.1f}")
Линейная регрессия: MAE = 41.5
Лес, все признаки (по умолчанию): MAE = 43.1
Лес, треть признаков: MAE = 42.3Линейная модель ошибается в среднем на 41,5 единицы, лес — на 43,1. Настройка max_features и min_samples_leaf сократила разрыв, но не перевернула результат. Зависимость здесь близка к линейной, и линейная регрессия ловит её лучше.
Обратите внимание на max_features. В регрессии scikit-learn по умолчанию берёт все признаки, и тогда лес отличается от обычного бэггинга деревьев только бутстрэпом. Попробуйте max_features=1/3 или "sqrt": деревья станут разнообразнее.
Лес не умеет экстраполировать
Дерево предсказывает среднее по листу, а листья построены на обучающих данных. Поэтому прогноз леса никогда не выйдет за пределы значений, которые он видел. Пример с прямой y = 2x, где x в обучении от 0 до 10:
import numpy as np
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression

X = np.arange(0, 11).reshape(-1, 1)   # x от 0 до 10
y = 2 * X.ravel()                     # y = 2x, максимум 20

forest = RandomForestRegressor(n_estimators=100, random_state=42).fit(X, y)
line = LinearRegression().fit(X, y)

for x in [5, 10, 20, 50]:
    print(f"x = {x:>2}: лес {forest.predict([[x]])[0]:5.1f}, линейная {line.predict([[x]])[0]:5.1f}")
x = 5: лес 9.4, линейная 10.0
x = 10: лес 19.0, линейная 20.0
x = 20: лес 19.0, линейная 40.0
x = 50: лес 19.0, линейная 100.0При x = 50 лес выдаёт те же 19, что и при x = 10. Для предиктивной аналитики с растущим трендом это серьёзная проблема: модель не увидит рост, которого не было в истории.
Важность признаков: два способа и подвох
Лес умеет сказать, какие признаки повлияли на прогноз. Это полезно в бизнес-задачах, где модель приходится объяснять заказчику. Способов два, и они дают разные ответы.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.inspection import permutation_importance
import pandas as pd

X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y
)
forest = RandomForestClassifier(n_estimators=300, n_jobs=-1, random_state=42)
forest.fit(X_train, y_train)

mdi = pd.Series(forest.feature_importances_, index=X.columns)
print("По загрязнённости (MDI), топ-5:")
print(mdi.sort_values(ascending=False).head(5).round(3).to_string())

perm = permutation_importance(forest, X_test, y_test, n_repeats=10, random_state=42, n_jobs=-1)
pi = pd.Series(perm.importances_mean, index=X.columns)
print("\nПерестановочная важность на тесте, топ-5:")
print(pi.sort_values(ascending=False).head(5).round(3).to_string())
По загрязнённости (MDI), топ-5:
worst perimeter 0.146
worst area 0.144
worst concave points 0.115
mean concave points 0.098
worst radius 0.072
Перестановочная важность на тесте, топ-5:
worst texture 0.005
worst perimeter 0.003
worst smoothness 0.001
worst concave points 0.001
worst concavity 0.001Первый способ, feature_importances_, считает, насколько каждый признак уменьшил загрязнённость узлов при обучении (Mean Decrease in Impurity). Второй перемешивает значения одного признака на тесте и смотрит, насколько упала точность. Оба результата собраны в pd.Series из библиотеки Pandas: так их можно отсортировать одной строкой.
У способа MDI два недостатка, о которых предупреждает документация scikit-learn:
- он считается по обучающим данным и не обязательно показывает, какие признаки важны для прогноза на новых данных;
- он завышает важность признаков с большим числом уникальных значений.
Почему тогда перестановочная важность в примере почти нулевая? Признаки сильно связаны: корреляция между worst perimeter и worst radius 0,994, между worst perimeter и worst area 0,978. Перемешали периметр — модель берёт ту же информацию из радиуса и площади.
Этот эффект описан в руководстве scikit-learn по перестановочной важности: когда два признака коррелируют, важность обоих выходит ниже, хотя на деле они могут быть важны.
Решение: перед тем как делать выводы о важности, посмотрите корреляции. Сильно связанные признаки сгруппируйте или оставьте один из группы, и только потом считайте важность.
 Канал основателя Checkroi Вани БуявцаЗабирайте промпты и обучение по нейросетям в моём Телеграм-каналеБольше 3 800 человек уже применяют Claude Code, ChatGPT и другие нейросети в работе, учёбе, бизнесе и жизниПерейти в канал
Плюсы и минусы случайного леса
| Плюсы | Минусы |
|---|---|
| Хороший результат без долгой настройки | Модель тяжёлая: сотни полных деревьев занимают память |
| Решает и классификацию, и регрессию | Прогноз медленнее, чем у одного дерева или линейной модели |
| Не нужно масштабировать признаки | Не экстраполирует за пределы обучающих данных |
| OOB-оценка без отдельной валидации | Трудно объяснить отдельный прогноз, в отличие от одного дерева |
| Деревья строятся параллельно на всех ядрах | На почти линейных зависимостях уступает простым моделям |
Про масштабирование стоит пояснить. Дерево делит данные порогами вида «признак больше 12,5», и порогу всё равно, в каких единицах признак. Если прогнать данные из первого примера через StandardScaler и обучить лес заново с тем же random_state, все 143 прогноза совпадут с прогнозами леса на сырых данных.
Случайный лес или градиентный бустинг
Это два главных ансамбля деревьев, и их постоянно сравнивают. Короткий ответ: лес проще запустить, а у бустинга больше рычагов настройки, и без неё он легко проигрывает.
| Случайный лес | Градиентный бустинг | |
|---|---|---|
| Как строятся деревья | независимо и параллельно | по очереди, каждое следующее исправляет ошибки ансамбля |
| Какие деревья | глубокие | обычно неглубокие |
| Больше деревьев | ошибка выходит на плато | число деревьев подбирают вместе со скоростью обучения |
| Настройка | работает почти на значениях по умолчанию | чувствителен к learning_rate, глубине, числу итераций |
| Библиотеки | scikit-learn | scikit-learn, XGBoost, LightGBM, CatBoost |
Про связку числа деревьев и скорости обучения в бустинге прямо сказано в документации scikit-learn по бустингу: параметр learning_rate сильно взаимодействует с n_estimators. Поэтому их подбирают вместе, а у леса число деревьев можно просто поднять.
Рабочий порядок на новой задаче такой: сначала простая модель как точка отсчёта, потом случайный лес, потом бустинг. Как ансамбли устроены в целом, рассказано в разделе про ансамблевые методы в статье о машинном обучении для неспециалистов.
Когда брать случайный лес, а когда нет
Лес хорош как первая серьёзная модель на табличных данных. Берите его, если:
- данные табличные: клиенты, транзакции, заявки, показания датчиков;
- признаки разного типа и масштаба, а времени на подготовку мало;
- нужен быстрый ориентир по качеству, прежде чем настраивать что-то сложнее;
- нужно понять, какие признаки вообще влияют на результат.
Ищите другую модель, если:
- прогноз должен выходить за пределы истории, например при растущем тренде;
- модель должна работать на слабом устройстве, где важны память и скорость;
- на входе картинки, звук или текст: для них строят нейросети;
- каждое решение надо объяснить правилом «если — то», как в одном дереве.
Потренироваться на реальных задачах удобно на Kaggle: там много открытых табличных датасетов, на которых лес можно сравнить с бустингом.
Где освоить машинное обучение системно
Случайный лес — одна модель из набора, который нужен в работе. Чтобы уверенно выбирать алгоритм под задачу, готовить данные, проверять качество и выводить модели в работу, нужна системная база: Python, статистика, scikit-learn, метрики.
Этим занимаются специалисты по машинному обучению и ML-инженеры, а путь в профессию по шагам расписан в статье о том, как стать Data Scientist. Ниже собраны программы по машинному обучению с ценами и сроками.
| Курс | Школа | Стоимость со скидкой | В рассрочку | Длительность | Обзор курса от Checkroi |
|---|---|---|---|---|---|
| Machine Learning с нуля до Junior Перейти на сайт курса | Skillbox | 123 543 ₽ | 4384 ₽/мес. | 9 месяцев | Обзор курса |
| Бакалавриат «Data Science & Machine Learning» Перейти на сайт курса | Skillbox | 75 000 ₽ | - | 48 месяцев | Обзор курса |
| Машинное обучение Перейти на сайт курса | Нетология | 43 600 ₽ | 2598 ₽/мес. | 10 месяцев | Обзор курса |
| Machine Learning. Продвинутый уровень Перейти на сайт курса | OTUS | 65 000 ₽ | 8000 ₽/мес. | 5 месяцев | Обзор курса |
| Machine Learning Engineer с нуля Перейти на сайт курса | Skillbox | 69 000 ₽ | - | 9 месяцев | Обзор курса |
Больше программ — в полном каталоге курсов по машинному обучению