AIOps расшифровывается как применение искусственного интеллекта к ИТ-эксплуатации. На практике это машинное обучение поверх данных мониторинга: система сама находит аномалию, связывает разрозненные сигналы в один инцидент и подсказывает причину. За аббревиатурой стоит способ работы с эксплуатацией, а не должность.
Разрыв между шумихой и рынком видно по цифрам. На 22 сентября 2026 года поиск по слову «AIOps» на hh.ru отдаёт 5 вакансий по всей России, по слову «DevOps» 1633, по «SRE» 280, по «MLOps» 264. То есть отдельной профессии «AIOps-инженер» в найме пока почти нет, а сам подход живёт внутри вакансий DevOps и SRE.
Ниже разбираем, что именно вкладывают в AIOps, чем он отличается от DevOps, SRE, MLOps и наблюдаемости, как выглядит путь данных от сырого лога до автоматического действия, на каких платформах это собирают в России и что должен уметь инженер, которому такую задачу поручили. Цифры по рынку труда сняты вручную в сентябре 2026 года, определения взяты из документации вендоров и открытых стандартов.
 CheckroiПодборка курсов для DevOps-инженеров119 курсов • 19 школСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Что такое AIOps простыми словами
Представьте дежурную смену, на которую за ночь прилетело 900 уведомлений. Половина из них повторы одного и того же сбоя, треть последствия первой поломки, и где-то среди них лежит одно сообщение, с которого всё началось. Человек разбирает эту гору руками и тратит на поиск причины часы.
AIOps берёт на себя именно разбор. Алгоритмы читают метрики, логи и трассировки, отсекают фоновые колебания, склеивают повторы в одну карточку и показывают дежурному не 900 строк, а несколько связанных событий с версией о причине.
IBM описывает это как применение возможностей искусственного интеллекта для автоматизации и оптимизации управления ИТ-услугами и выделяет четыре шага поверх собранных данных: отделить значимый сигнал от шума, найти первопричину, автоматизировать реакцию вплоть до исправления без участия человека и постоянно дообучаться на новых инцидентах.
Короткая формула. Мониторинг отвечает на вопрос «что сломалось», AIOps пытается ответить на вопрос «почему сломалось и что с этим делать».
Важная оговорка: речь не про универсальный ИИ, который понимает вашу инфраструктуру. Работают довольно приземлённые вещи: статистика временных рядов, кластеризация событий, правила подавления повторов. Магии в этом меньше, чем в названии.
Учат этому тоже не отдельно: навыки набираются на программах по эксплуатации и автоматизации инфраструктуры, которые собраны в каталоге онлайн-курсов для DevOps-инженеров.
Откуда взялся термин и что в него вкладывают
Слово появилось в 2016 году в исследованиях Gartner и сначала расшифровывалось как algorithmic IT operations, то есть «алгоритмическая эксплуатация». Примерно через год расшифровку поменяли на artificial intelligence for IT operations, и в этом виде аббревиатура разошлась по рынку.
Единого стандарта за термином не стоит. Каждый вендор наполняет его своим набором функций, поэтому две платформы с одинаковой подписью «AIOps» на сайте могут уметь принципиально разное. При выборе смотреть надо на конкретные функции, а не на аббревиатуру в заголовке лендинга.
Общий знаменатель всё же есть, и он сводится к четырём вещам: единый сбор телеметрии, автоматическое обнаружение аномалий, корреляция событий в инциденты и подсказка о первопричине. Всё остальное уже надстройки конкретного продукта.
С 2024 года к аббревиатуре добавилась вторая волна: вендоры начали встраивать в платформы большие языковые модели и называть результат agentic AIOps. Идея в том, чтобы дежурный получал не карточку с графиками, а текстовое объяснение инцидента и предложенный план действий, а в перспективе получал агента, который сам выполняет часть шагов.
Относиться к этому слою стоит осторожнее, чем к базовому. Корреляция событий работает на статистике и проверяется метриками, а языковая модель формулирует убедительный текст независимо от того, верна ли догадка. Внедрять такое имеет смысл поверх уже настроенной корреляции, а не вместо неё.
Канал основателя Checkroi Вани Буявца3 700 человек читают мой Телеграм-канал про нейросетиСобрал промпты для Claude Code и ChatGPT, разборы ИИ-инструментов и лайфхаки по продвижению бизнеса в одном местеПрисоединитьсяAIOps, DevOps, SRE, MLOps и observability: кто за что отвечает
Больше всего путаницы именно здесь: аббревиатуры звучат похоже, живут в одном отделе и иногда описывают работу одного и того же человека. Разница в том, на какой вопрос каждая из практик отвечает.
| Практика | Отвечает на вопрос | Главный объект работы | Кто обычно делает | Частые заблуждения |
|---|---|---|---|---|
| AIOps | Почему сломалось и можно ли починить без человека | Поток событий и метрик эксплуатации | Команда эксплуатации, платформенная команда | В большинстве компаний это не отдельная должность |
| DevOps | Как быстро и безопасно довезти код до продакшена | Пайплайны сборки и доставки, инфраструктура как код | DevOps-инженер | Анализом инцидентов через машинное обучение не занимается |
| SRE | Насколько надёжен сервис и укладываемся ли мы в бюджет ошибок | SLO, бюджеты ошибок, устойчивость | SRE-инженер | Это инженерная дисциплина, а не набор инструментов |
| MLOps | Как довезти и удержать в проде модель машинного обучения | Модели, датасеты, дрейф данных | ML-инженер, MLOps-инженер | Инфраструктурные инциденты вне его зоны |
| Observability | Достаточно ли данных, чтобы вообще понять состояние системы | Метрики, логи, трассировки | Платформенная команда | Отвечает за полноту данных, аналитика идёт следом |
Разница между двумя последними строками таблицы стоит отдельного абзаца, потому что её путают чаще всего. Стандарт OpenTelemetry определяет наблюдаемость как способность понять внутреннее состояние системы по её внешним проявлениям и называет три типа сигналов: трассировки, метрики и логи.
Observability отвечает за то, собраны ли данные, а AIOps за то, что с ними делают дальше. Без первого второе не запускается: алгоритму нечего анализировать, если телеметрии нет или она рваная.
Отношения с MLOps ещё интереснее. AIOps применяет машинное обучение к эксплуатации, MLOps применяет эксплуатацию к машинному обучению. Направление ровно противоположное, хотя буквы почти те же. Если вам ближе вторая сторона, начните с разбора, кто такой ML-инженер и как устроены модели машинного обучения. Есть и третья ветка на том же поле, безопасность, её закрывает DevSecOps-инженер.
Как работает AIOps: от сырого лога до готового действия
Путь данных примерно одинаков у всех платформ, меняются только детали реализации. Разберём его по шагам: так видно, где алгоритмы помогают, а где остаётся ручная работа.
Шаг 1: сбор телеметрии
Платформа подключается к источникам: системам мониторинга, логам приложений, трассировкам, системе тикетов, данным о релизах и изменениях конфигурации. Чем разнороднее источники, тем полезнее следующий шаг.
На практике половина проекта уходит именно сюда. Данные лежат в пяти разных системах, у каждой свой формат имён и свои часовые пояса.
Шаг 2: нормализация
Один и тот же сервер в системе мониторинга называется srv-app-01, в тикетах называется «сервер приложений», в CMDB числится под инвентарным номером. Пока эти записи не сведены к одной сущности, никакая корреляция не заработает.
Решение: единая модель ресурсов, куда каждый источник приводится при загрузке. Скучный шаг, который определяет качество всего остального.
Шаг 3: обнаружение аномалий
Алгоритм строит представление о нормальном поведении метрики и отмечает отклонения. Это работает точнее статичного порога: ночной провал нагрузки для интернет-магазина нормален, а такой же провал в полдень вторника уже повод для тревоги.
Механика доступна не только в коммерческих платформах. У OpenSearch есть открытый модуль anomaly detection для потоковых данных. В облачной версии Grafana есть функции машинного обучения для прогноза метрик и поиска выбросов, но это платный сервис, а в самостоятельно развёрнутой версии их нет.
CheckroiПодборка курсов по Grafana66 курсов • 14 школСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Шаг 4: корреляция и дедупликация
Те самые 900 уведомлений схлопываются в несколько карточек. Платформа сопоставляет события по времени, топологии и зависимостям сервисов и выдвигает версию о первопричине.
Здесь же обычно живёт защита от шторма алертов: если после падения базы данных посыпались все зависимые сервисы, дежурный получает одно сообщение про базу, а не сто про её потребителей.
Шаг 5: действие
Дальше два варианта. Либо карточка уходит человеку с собранным контекстом, либо срабатывает сценарий автоматики: перезапуск, откат релиза, расширение дискового раздела.
Автоматику включают не сразу. Сначала система месяцами работает в режиме подсказки, и только после того, как её версии о причинах начинают сходиться с реальностью, ей отдают права на действие.
На что смотреть при оценке. Две метрики: MTTA, то есть время от возникновения проблемы до того, как за неё кто-то взялся, и MTTR, время до восстановления. Если после внедрения не сдвинулась ни одна, платформа работает как дорогая витрина графиков.
Четыре ступени зрелости: где вы находитесь сейчас
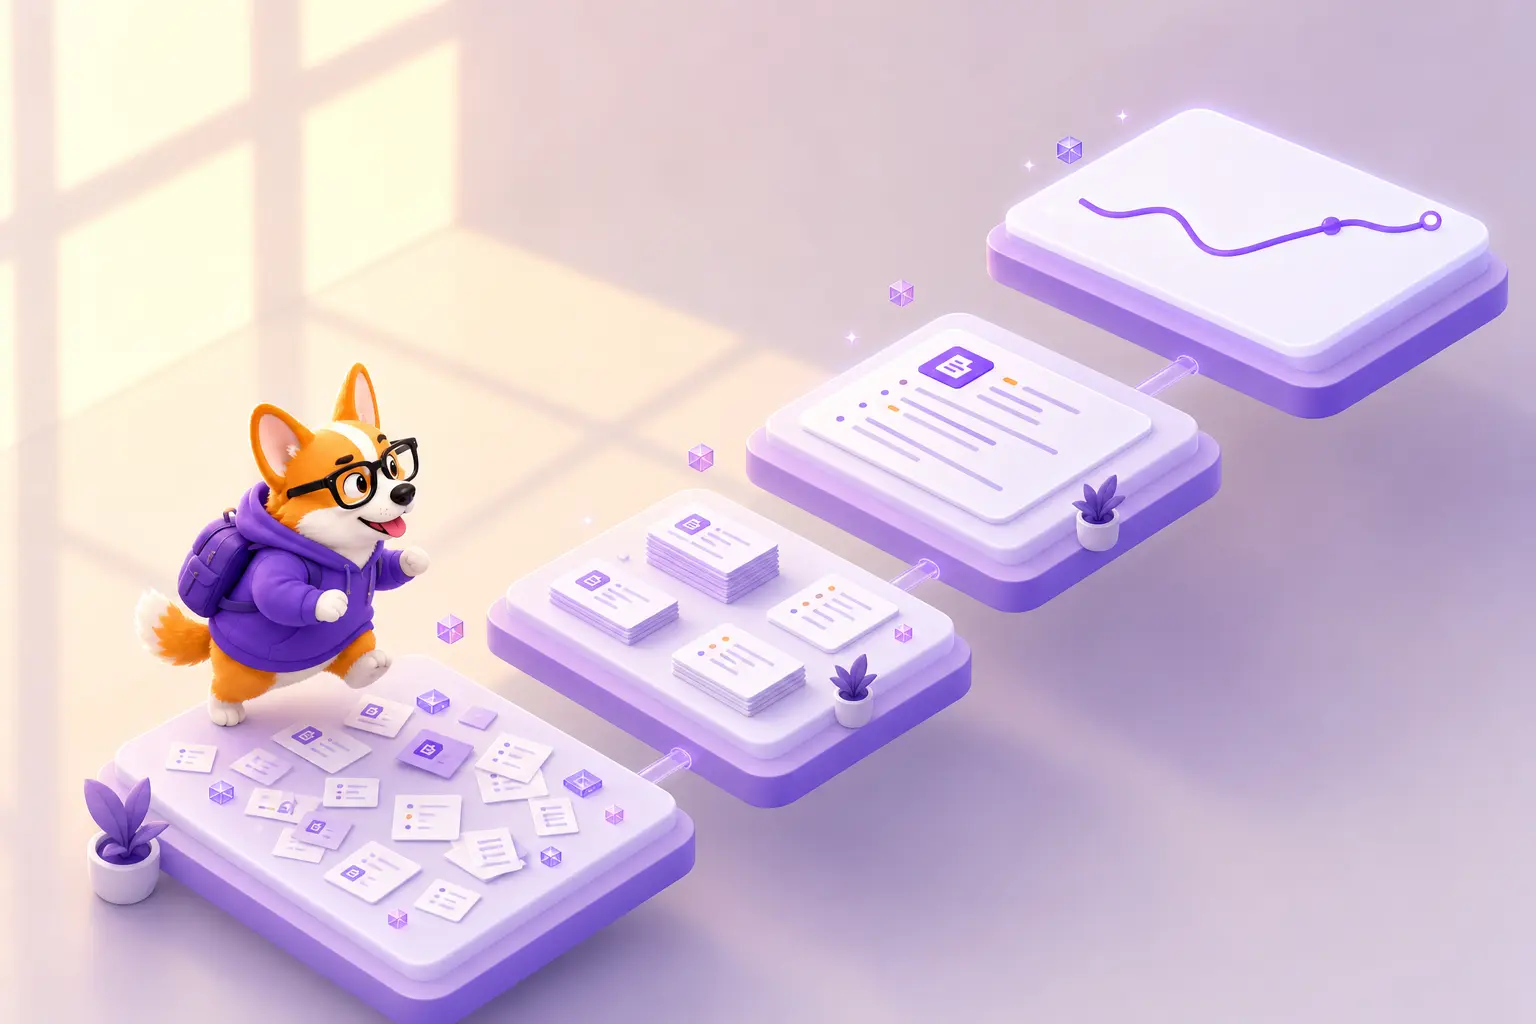
Переход к AIOps происходит не одним движением. Между «у нас есть графики» и «система чинит типовые сбои сама» лежит несколько ступеней, и перепрыгнуть их не получается: каждая следующая опирается на данные и доверие, накопленные на предыдущей.
| Ступень | Что уже есть | Что решает человек | Типичный барьер к следующей ступени |
|---|---|---|---|
| Реактивная | Пороговые оповещения, дашборды | Всё: замечает, разбирает, чинит | Телеметрия собрана не со всех систем |
| Наблюдаемая | Метрики, логи и трассировки в одном месте | Разбирает поток и ищет причину | Ресурсы в разных системах названы по-разному |
| Аналитическая | Поиск аномалий, схлопывание повторов, версии о причине | Принимает решение и выполняет действие | Слишком много ложных срабатываний, платформе не доверяют |
| Автоматизированная | Сценарии реакции на типовые инциденты | Разбирает нетиповое и развивает сценарии | Нет отката и ограничений, автоматике боятся отдать права |
Барьеры в правой колонке важнее самих ступеней. Чаще всего проект застревает между второй и третьей: платформу купили, данные подключили, но имена ресурсов не сведены, корреляция даёт мусор, и команда возвращается к ручному разбору.
Проверка на честность. Спросите дежурных, открывают ли они новую платформу первой при инциденте или по привычке идут в старые дашборды. Ответ точнее любых отчётов о внедрении.
Какие задачи AIOps закрывает на практике
Набор сценариев у большинства внедрений повторяется, и он довольно приземлённый.
- Разбор потока уведомлений. Схлопывание повторов и группировка связанных событий, обычно первое, ради чего всё затевается.
- Поиск первопричины. Платформа показывает цепочку: замедлился запрос к базе, следом выросли очереди, следом посыпались таймауты у фронтенда.
- Предиктивные сценарии. Диск заполнится через четыре дня при текущем темпе роста, сертификат истекает через неделю, память утекает с постоянной скоростью.
- Поиск аномалий в поведении пользователей. Конверсия просела только в одном регионе и только на Android, это сигнал о проблеме, которую инфраструктурный мониторинг не увидит.
- Разгрузка первой линии поддержки. Типовые обращения закрываются сценарием без эскалации.
Обратите внимание, чего в списке нет: AIOps не проектирует архитектуру, не пишет тесты и не принимает решений об изменениях. Это инструмент эксплуатации, а не замена инженерам. Тем же свойством обладают и соседние практики автоматизации, например управление конфигурациями через Chef: оно снимает рутину, но не отвечает за решения.
 Канал основателя Checkroi Вани БуявцаЗабирайте промпты и обучение по нейросетям в моём Телеграм-каналеБольше 3 700 человек уже применяют Claude Code, ChatGPT и другие нейросети в работе, учёбе, бизнесе и жизниПерейти в канал
На чём это строят: платформы и открытые инструменты
Рынок делится на три слоя, и понимать разницу полезно ещё до разговора с вендором.
| Слой | Что делает | Примеры | Когда достаточно только его |
|---|---|---|---|
| Сбор и хранение телеметрии | Собирает метрики, логи и трассировки, хранит историю | Prometheus, Zabbix, OpenTelemetry-коллектор | Небольшая инфраструктура, несколько десятков хостов |
| Визуализация и алертинг | Рисует дашборды, рассылает уведомления, базовые прогнозы | Grafana, OpenSearch Dashboards | Поток уведомлений дежурный разбирает без перегрузки |
| Корреляция и автоматика | Сводит события в инциденты, ищет причину, запускает сценарии | Monq, решения Naumen, возможности Elastic | Десятки систем-источников и сотни уведомлений в сутки |
Для российских компаний вопрос обычно упирается не в функции, а в закупку. Monq заявляет о присутствии в реестре отечественного ПО с 2020 года, и для организаций с требованиями по импортозамещению это условие допуска к тендеру. Проверить статус конкретного продукта можно в едином реестре российских программ.
Открытый стек закрывает больше, чем принято думать. Prometheus с Grafana плюс модуль поиска аномалий уже дают предиктивные оповещения, а связка с Kubernetes добавляет автоматический перезапуск проблемных подов. Отдельная платформа нужна, когда источников становится много и корреляцию перестаёт тянуть набор правил.
CheckroiПодборка курсов по Prometheus55 курсов • 13 школСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Кто такой AIOps-инженер и чем он занят
Отдельной устоявшейся профессии в России пока нет, и это видно по найму. Те пять вакансий с hh.ru, о которых шла речь в начале, по названиям выглядят как SRE и DevOps с добавкой про ИИ, самостоятельной роли среди них нет.
Человек, который на практике занимается AIOps, обычно приходит из эксплуатации. Его рабочая неделя выглядит примерно так:
- Подключение источников. Настроить сбор с очередной системы, договориться с её владельцем о формате и доступах.
- Наведение порядка в именах. Свести записи об одном ресурсе из разных систем в одну сущность.
- Настройка правил корреляции. Описать зависимости между сервисами, чтобы платформа понимала, что от чего зависит.
- Работа с качеством моделей. Разобрать ложные срабатывания, подправить чувствительность, отсеять метрики, которые шумят без смысла.
- Сценарии автоматики. Написать и протестировать реакции на типовые инциденты, обязательно с откатом.
- Разбор постфактум. После крупного сбоя проверить, увидела ли платформа причину и почему промолчала, если нет.
Больше всего времени уходит на два первых пункта. Модели машинного обучения в этой работе идут готовым компонентом платформы, инженер их не обучает.
Ближе всего к этой роли по содержанию работы стоит инженер надёжности: обе занимаются устойчивостью сервиса, только с разных сторон. Программы по этому направлению собраны в разделе курсов по SRE.
Что нужно уметь
Набор навыков ближе к эксплуатации, чем к науке о данных.
- Инфраструктура и сети. Без понимания, как устроен продакшен, правила корреляции писать не из чего.
- Системы мониторинга. Prometheus, Zabbix, Grafana, язык запросов к метрикам.
- Логи и трассировки. Сбор, парсинг, структурирование, стандарт OpenTelemetry.
- Скриптование. Python или Go для интеграций и сценариев автоматики.
- Базовая статистика. Отличать сезонность от тренда и выброс от нового нормального уровня.
- Процессы эксплуатации. Дежурства, эскалации, разборы инцидентов.
CheckroiПодборка курсов по Zabbix19 курсов • 9 школСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Неочевидный навык здесь, умение договариваться. Половина работы состоит из переговоров с владельцами чужих систем о доступах и форматах данных, и никакой алгоритм этот разговор не заменит.
Про подход Google к тому, какие сигналы вообще стоит выносить в оповещения, полезно прочитать главу о мониторинге распределённых систем в книге по SRE: она объясняет разницу между алертами по симптомам и по причинам, и без этой дисциплины любая платформа быстро тонет в шуме.
Сколько платят и сколько вакансий
По деньгам ориентироваться приходится не на «AIOps», а на смежные роли: рынок платит за DevOps и SRE, а работа с ИИ в мониторинге идёт внутри этих позиций строкой в требованиях.
Масштаб спроса на сентябрь 2026 года такой: 1633 вакансии по слову «DevOps» и 280 по «SRE» против 5 по «AIOps». Из вакансий DevOps зарплату в объявлении указывают примерно в 370 случаях, остальные обсуждают её на собеседовании, что для этого сегмента норма.
Подробный разбор вилок по грейдам, городам и формату занятости собран в отдельном материале про то, сколько зарабатывает DevOps-инженер и почему SRE в среднем стоит дороже.
Как войти в это направление
Прямого входа «с улицы в AIOps» нет: чтобы настраивать корреляцию инцидентов, нужно сначала поработать с самими инцидентами. Реалистичных дорог две. Первая, вырасти из администрирования через системное администрирование и эксплуатацию. Вторая, зайти со стороны разработки через DevOps-практики и инфраструктуру как код.
Полный разбор второго пути с картой на 12 месяцев и требованиями к первому офферу есть в статье о том, как стать DevOps-инженером.
Как внедряют и на чём спотыкаются
Порядок шагов у большинства проектов общий, и отклонение от него обходится дорого.
- Выбрать больную точку. Не «внедрить AIOps», а «сократить время разбора ночных инцидентов» или «убрать шторм уведомлений при падении базы». Измеримая цель определяет, какие данные подключать первыми.
- Навести порядок в телеметрии. Проверить, со всех ли значимых систем идут метрики и логи, и привести имена ресурсов к единому виду.
- Запустить в режиме наблюдения. Несколько месяцев платформа считает и предлагает версии, но ничего не делает. Инженеры сверяют её догадки с реальными разборами инцидентов.
- Отдать автоматике первый сценарий. Начинают с безопасного и обратимого: перезапуск сервиса, расширение раздела, откат последнего релиза.
- Расширять по одному. Каждый новый сценарий проходит тот же путь: сначала подсказка, потом действие.
Типичных ошибок тоже немного, и они повторяются от проекта к проекту.
- Подключить всё сразу. Сорок источников в первый месяц дают не полноту картины, а шум, в котором невозможно оценить качество корреляции.
- Пропустить нормализацию. Самая скучная часть, которую чаще всего откладывают, и именно она определяет, заработает корреляция или нет.
- Отдать автоматике права без отката. Сценарий, который не умеет вернуть систему в исходное состояние, однажды превратит мелкий сбой в крупный.
- Мерить успех количеством дашбордов. Показатели проекта, это время реакции и время восстановления, а не число экранов.
- Оставить проект без владельца. Платформа требует постоянной подстройки: меняется инфраструктура, ломаются правила корреляции. Без ответственного она деградирует за полгода.
Когда AIOps не нужен
Честный раздел, которого обычно нет в материалах вендоров. Есть ситуации, где платформа не окупится, и распознать их лучше до закупки.
- Инфраструктура умещается в несколько десятков хостов. Дежурный разбирает поток уведомлений сам, корреляции нечего схлопывать.
- Телеметрии почти нет. Алгоритму нужны исторические данные. Сначала наблюдаемость, потом аналитика поверх неё.
- Причина шума лежит не в мониторинге. Если уведомления сыплются из-за неудачных порогов и заброшенных проверок, чистка правил даст больше, чем машинное обучение.
- Нет процесса дежурств. Платформа найдёт причину, но если инцидент некому взять, время восстановления не изменится.
И отдельный случай, ожидание, что система разберётся во всём сама. Первые месяцы она учится на вашей инфраструктуре и ошибается, а инженер разбирает ложные срабатывания. Заложите на это время.
Где научиться
Курсов именно по AIOps на российском рынке практически нет, и это закономерно: направление собирают из навыков смежных областей. Практический путь такой: идти через программы по DevOps, эксплуатации и мониторингу, а поверх них добирать статистику и работу с данными.
В каталоге собраны программы по DevOps-направлению с описанием, сроками и ценами, включая курсы, где отдельные модули посвящены мониторингу, логированию и надёжности.
| Курс | Школа | Стоимость со скидкой | В рассрочку | Длительность | Обзор курса от Checkroi |
|---|---|---|---|---|---|
| Профессия «DevOps-инженер PRO» Перейти на сайт курса |  Skillbox | 105 000 ₽ | 5783 ₽/мес. | 12 месяцев | Обзор курса |
| Профессия «DevOps-инженер с нуля» Перейти на сайт курса |  Нетология | 189 000 ₽ | 7875 ₽/мес. | 24 месяца | Обзор курса |
| DevOps-инженер Перейти на сайт курса |  Эдюсон | 119 900 ₽ | 4995 ₽/мес. | 7 месяцев | Обзор курса |
| Профессия DevOps-инженер с нуля + ИИ Перейти на сайт курса | Skillbox | 119 988 ₽ | 3333 ₽/мес. | 9 месяцев | Обзор курса |
| Специализация «DevOps-инженер» Перейти на сайт курса | Нетология | 130 200 ₽ | 5425 ₽/мес. | 12 месяцев | Обзор курса |
| ДО Профессия DevOps-инженер 2.0 Перейти на сайт курса |  GeekBrains | 141 578 ₽ | 3933 ₽/мес. | 4 месяца | Обзор курса |
| DevOps-инженер Перейти на сайт курса |  SkillFactory | 118 404 ₽ | 3289 ₽/мес. | 6 месяцев | Обзор курса |
| Devops-инженер с нуля: расширенный курс Перейти на сайт курса | Нетология | 134 600 ₽ | 4797 ₽/мес. | 19 месяцев | Обзор курса |
| Devops-инженер с нуля Перейти на сайт курса | Нетология | 115 000 ₽ | 4397 ₽/мес. | 14 месяцев | Обзор курса |
| DevOps-инженер с нуля Перейти на сайт курса |  Hexlet | 99 000 ₽ | 5574 ₽/мес. | 14 месяцев | Обзор курса |
Больше программ — в полном каталоге курсов по DevOps
Главное об AIOps
AIOps сводится к машинному обучению поверх данных мониторинга ради трёх вещей: меньше шума в уведомлениях, быстрее найденная причина и автоматика для типовых случаев. Термин родился в Gartner в 2016 году, единого стандарта за ним не стоит, поэтому оценивать платформы надо по функциям.
Как профессия в России направление ещё не оформилось: 5 вакансий против 1633 по DevOps на сентябрь 2026 года. Практический вывод для карьеры простой. Учиться стоит на инженера эксплуатации, который умеет работать с телеметрией и автоматикой. Такой специалист нужен рынку прямо сейчас, а навык применения ИИ в мониторинге станет для него дополнительным аргументом на собеседовании.