Чтобы закэшировать функцию в Python, импортируйте декоратор lru_cache из модуля functools и поставьте @lru_cache(maxsize=128) над её объявлением. После этого повторный вызов с теми же аргументами не запускает функцию заново, а достаёт готовый результат из словаря. Если ограничивать размер кэша не нужно, с Python 3.9 есть короткая запись @cache, это то же самое, что lru_cache(maxsize=None).
Ниже разберём, как это работает на примере чисел Фибоначчи, что значат параметры maxsize и typed, какие ещё есть способы кэширования и на каких ошибках декоратор ломает программу. Если с декораторами вы пока не сталкивались, сначала стоит освежить, как устроены функции в Python.
 CheckroiПодборка курсов по Python569 курсов • 52 школыСравните цены, школы, программу и найдите выгодные предложения по обучениюСравнить→
Как подключить lru_cache за три шага
Кэш нужен функции, которая долго считает и часто получает одни и те же аргументы. Классический пример: числа Фибоначчи через рекурсию: без кэша функция пересчитывает одни и те же значения миллионы раз.
- Импортируйте декоратор:
from functools import lru_cache. - Поставьте
@lru_cacheстрокой вышеdef. Без скобок размер кэша будет 128 записей, со скобками его можно задать:@lru_cache(maxsize=1000). - Вызывайте функцию как обычно. Проверить, что кэш работает, можно методом
cache_info().
Вот сравнение двух одинаковых функций, одна из которых с декоратором:
import time
from functools import lru_cache


def fib_slow(n):
    if n < 2:
        return n
    return fib_slow(n - 1) + fib_slow(n - 2)


@lru_cache(maxsize=None)
def fib_fast(n):
    if n < 2:
        return n
    return fib_fast(n - 1) + fib_fast(n - 2)


start = time.perf_counter()
print(fib_slow(32))
print(f"без кэша: {time.perf_counter() - start:.2f} с")

start = time.perf_counter()
print(fib_fast(32))
print(f"с кэшем: {time.perf_counter() - start:.6f} с")
print(fib_fast.cache_info())
Вывод (секунды на другом компьютере будут другими, а разница в тысячи раз сохранится):
2178309
без кэша: 0.19 с
2178309
с кэшем: 0.000039 с
CacheInfo(hits=30, misses=33, maxsize=None, currsize=33)
Разница в несколько тысяч раз, и объяснение простое. Медленная версия для fib_slow(32) вызывает себя больше семи миллионов раз, потому что каждое значение считается заново в каждой ветке. Быстрая считает каждое число от 0 до 32 ровно один раз: это 33 промаха (misses) в выводе, а 30 попаданий (hits) — повторные обращения, на которые ответил словарь. Подробнее о том, почему рекурсия без запоминания так разрастается, мы писали в статье про рекурсию в Python.
Что значит LRU и когда кэш выбрасывает значения
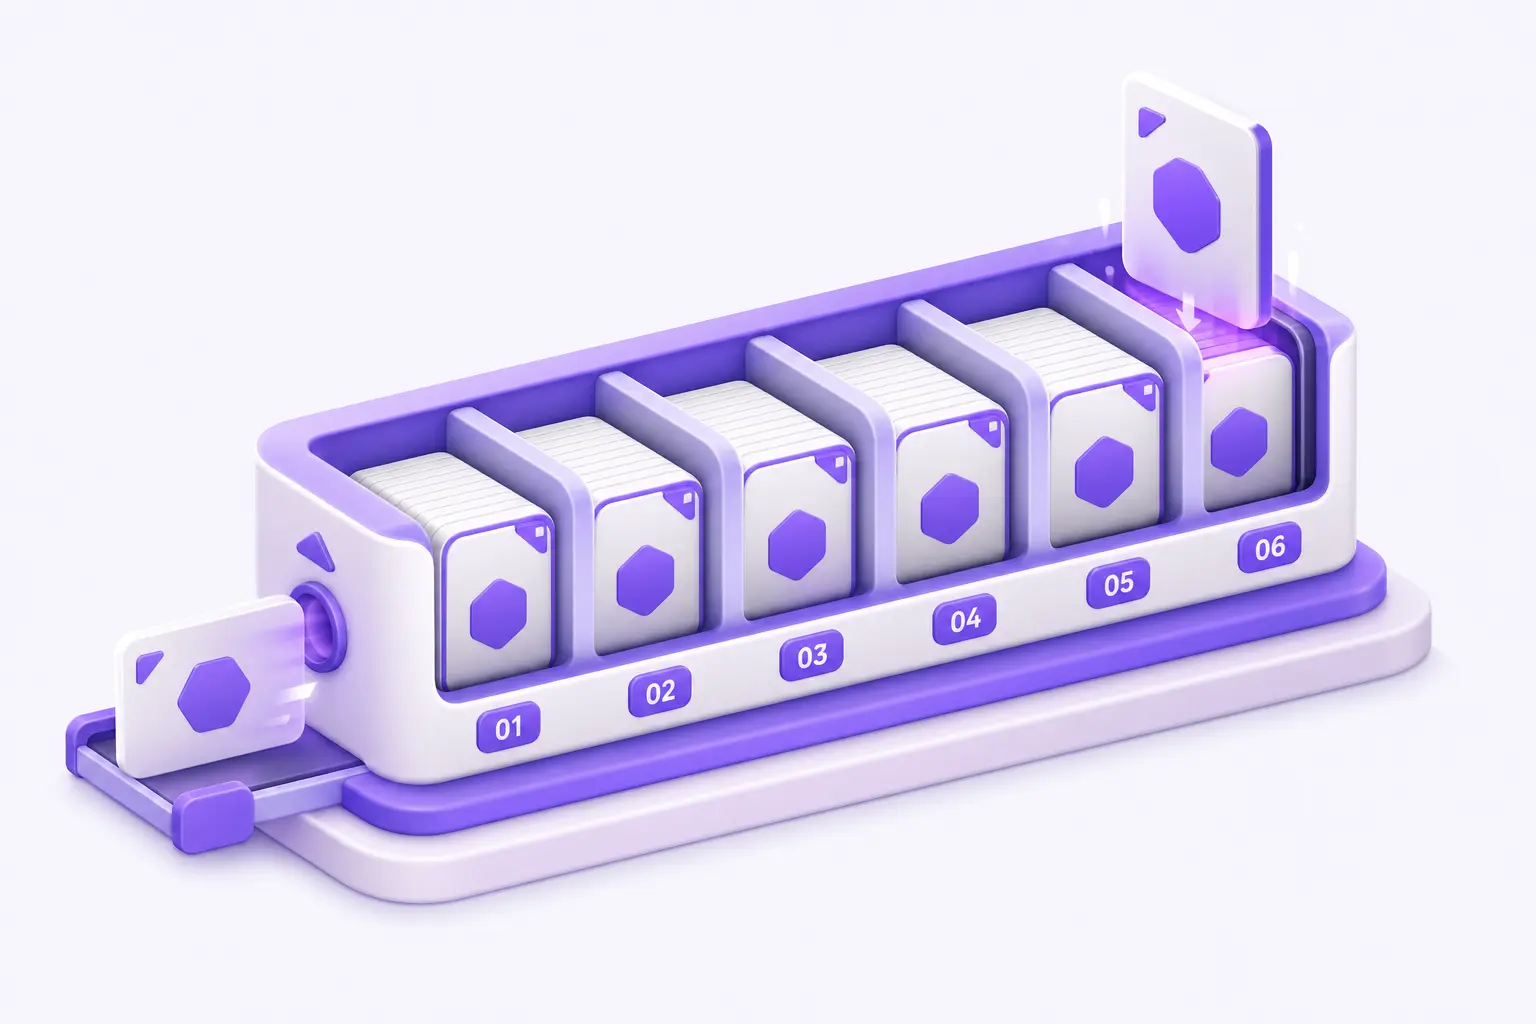
LRU расшифровывается как least recently used, то есть «давно не использованное». Когда кэш заполнен до maxsize, а приходит новый аргумент, декоратор выбрасывает ту запись, к которой дольше всех не обращались.
Логику проще увидеть на кэше из двух ячеек:
from functools import lru_cache


@lru_cache(maxsize=2)
def square(x):
    print(f"считаю {x}")
    return x * x


square(1)   # промах, кладём 1
square(2)   # промах, кладём 2
square(1)   # попадание, 1 становится самым свежим
square(3)   # промах, места нет: выбрасываем 2
square(2)   # промах: 2 уже вытеснено
print(square.cache_info())
считаю 1
считаю 2
считаю 3
считаю 2
CacheInfo(hits=1, misses=4, maxsize=2, currsize=2)Строка «считаю 1» не напечаталась второй раз: третий вызов взял результат из кэша и заодно сделал единицу самой свежей записью. Поэтому при вызове square(3) вылетела двойка, и следующий square(2) снова пошёл считать.
Канал основателя Checkroi Вани Буявца3 800 человек читают мой Телеграм-канал про нейросетиСобрал промпты для Claude Code и ChatGPT, разборы ИИ-инструментов и лайфхаки по продвижению бизнеса в одном местеПрисоединитьсяПо документации functools, LRU-кэш работает лучше всего, когда недавние вызовы хорошо предсказывают следующие. Ограничение размера нужно, чтобы кэш не рос бесконечно в долгоживущих процессах вроде веб-серверов.
Параметры lru_cache: maxsize и typed
У декоратора всего два параметра, и оба задаются при объявлении. Метод cache_parameters() их только показывает: по документации, правка возвращённого словаря ни на что не влияет.
| Параметр | По умолчанию | Что делает |
|---|---|---|
maxsize |
128 | Сколько последних результатов хранить. None отключает вытеснение, кэш растёт без ограничений |
typed |
False |
Если True, аргументы разных типов кэшируются отдельно: 3 и 3.0 дадут две записи |
С typed есть тонкость. Раз 3 == 3.0 и хэши у них совпадают, без флага второй вызов получит ответ, посчитанный для целого числа:
from functools import lru_cache


@lru_cache(maxsize=32)
def scale(x, k):
    return f"{type(x).__name__}: {x * k}"


@lru_cache(maxsize=32, typed=True)
def scale_typed(x, k):
    return f"{type(x).__name__}: {x * k}"


print(scale(3, 2), "|", scale(3.0, 2))
print(scale_typed(3, 2), "|", scale_typed(3.0, 2))
int: 6 | int: 6
int: 6 | float: 6.0В первой строке scale(3.0, 2) вернул «int: 6», хотя передавали дробное число. Если результат зависит от типа аргумента, ставьте typed=True. В документации есть оговорка: некоторые типы, например str и int, могут кэшироваться раздельно и без флага. На практике так бывает с функцией от одного аргумента, поэтому в примере их два. Как Python хранит и сравнивает целые числа, мы разбирали в статье про тип int.
Как проверить и очистить кэш
Декоратор добавляет функции три служебных метода и атрибут __wrapped__. Через них видно, сколько раз кэш сработал, и можно сбросить его без перезапуска программы.
cache_info(): именованный кортеж: попадания, промахи, лимит и текущий размер.cache_parameters(): словарь сmaxsizeиtyped, появился в Python 3.9.cache_clear(): удаляет все записи.__wrapped__: исходная функция без кэша, если нужно посчитать заново в обход.
from functools import lru_cache


@lru_cache(maxsize=128)
def slow_upper(text):
    return text.upper()


for word in ["кот", "пёс", "кот", "кот", "ёж"]:
    slow_upper(word)

print(slow_upper.cache_info())
print(slow_upper.cache_parameters())
slow_upper.cache_clear()
print(slow_upper.cache_info())
print(slow_upper.__wrapped__("без кэша"))
CacheInfo(hits=2, misses=3, maxsize=128, currsize=3)
{'maxsize': 128, 'typed': False}
CacheInfo(hits=0, misses=0, maxsize=128, currsize=0)
БЕЗ КЭШАПять вызовов дали два попадания (цикл for по списку подробно разобран в статье про списки в Python): слово «кот» посчитали один раз и дважды отдали из кэша. По соотношению hits и misses удобно подбирать maxsize. Если промахов много, а currsize упирается в лимит, кэш маловат.
Как lru_cache строит ключ и что происходит в потоках
Ключ кэша собирается из аргументов ровно в том виде, в каком их передали. Декоратор не знает, что price(1000, 100) и price(base=1000, discount=100) для функции одно и то же.
from functools import lru_cache


@lru_cache
def price(base, discount=0):
    return base - discount


price(1000, 100)
price(1000, discount=100)
price(base=1000, discount=100)
price(discount=100, base=1000)
print(price.cache_info())
CacheInfo(hits=0, misses=4, maxsize=128, currsize=4)Четыре вызова с одинаковым смыслом дали четыре промаха и четыре записи. В документации об этом сказано прямо: даже f(a=1, b=2) и f(b=2, a=1) могут попасть в разные записи из-за порядка именованных аргументов.
Решение: договоритесь в команде вызывать кэшируемую функцию одним способом и закрепите это в правилах оформления кода. Когда это сложно, сделайте тонкую обёртку без кэша, которая приводит аргументы к одному виду и зовёт кэшированную функцию позиционно.
Теперь потоки. Структура кэша при параллельной записи не ломается, но защиты от двойного вычисления нет: пока первый поток считает, второй не видит готового результата и считает сам.
import threading
import time
from functools import lru_cache

calls = 0


@lru_cache
def load(name):
    global calls
    calls += 1
    time.sleep(0.5)
    return name.upper()


threads = [threading.Thread(target=load, args=("report",)) for _ in range(3)]
for t in threads:
    t.start()
for t in threads:
    t.join()

print("функция отработала раз:", calls)
print(load.cache_info())
функция отработала раз: 3
CacheInfo(hits=0, misses=3, maxsize=128, currsize=1)Три потока одновременно запросили один и тот же отчёт, и функция отработала трижды, хотя запись в кэше в итоге одна. Для дешёвых вычислений это не страшно. Если внутри запрос к базе или платному API, поставьте вокруг вызова блокировку threading.Lock или прогрейте кэш до запуска потоков.
Пять способов кэширования в Python
lru_cache закрывает большинство задач, но не все. Иногда нужен кэш с временем жизни, иногда общий для нескольких процессов, а иногда хватает словаря.
Словарь вручную
Запоминание результатов функции называют мемоизацией, и вот как она выглядит изнутри. Декоратор хранит результаты в словаре, а ключом служит кортеж аргументов:
def memoize(func):
    cache = {}

    def wrapper(*args):
        if args not in cache:
            cache[args] = func(*args)
        return cache[args]

    wrapper.cache = cache
    return wrapper


@memoize
def fib(n):
    return n if n < 2 else fib(n - 1) + fib(n - 2)


print(fib(80))
print(len(fib.cache))
23416728348467685
81Для fib(80) в словаре оказалась 81 запись, по одной на каждое n от 0 до 80. Ручной вариант пригодится, когда нужна своя логика: например, хранить ключ не целиком или сбрасывать часть записей. Если со словарями пока неуверенно, посмотрите, как читать значения через get().
@cache без ограничения размера
Короткая запись для случая, когда записей заведомо немного. По документации, @cache возвращает то же, что lru_cache(maxsize=None), и работает быстрее lru_cache с ограничением размера, потому что ему не нужно ничего вытеснять.
from functools import cache


@cache
def factorial(n):
    return n * factorial(n - 1) if n else 1


print(factorial(10))
print(factorial(12))
print(factorial.cache_info())
3628800
479001600
CacheInfo(hits=1, misses=13, maxsize=None, currsize=13)Для factorial(12) функция досчитала только 12 и 11, а factorial(10) уже лежал в кэше: отсюда одно попадание.
cached_property для атрибутов класса
Если тяжёлое вычисление живёт в методе объекта, а объект после создания не меняется, удобнее @cached_property. Значение считается при первом обращении и дальше хранится как обычный атрибут экземпляра. Про классы и атрибуты подробно рассказано в статье про ООП на Python.
from functools import cached_property


class Report:
    def __init__(self, rows):
        self.rows = rows

    @cached_property
    def total(self):
        print("считаю сумму")
        return sum(self.rows)


r = Report([120, 340, 95])
print(r.total)
print(r.total)
r.rows.append(1000)
print(r.total)
del r.total
print(r.total)
считаю сумму
555
555
555
считаю сумму
1555Обратите внимание на третью строку: сумма осталась 555, хотя в список добавили 1000. Свойство не знает об изменениях данных, сбросить его можно только через del r.total.
Кэш с временем жизни через cachetools
Стандартный lru_cache не умеет забывать записи по времени. Для настроек, курсов, ответов API нужен TTL, и его даёт сторонняя библиотека cachetools. Ставится она через pip, а в проект её стоит записать в requirements.txt.
import time
from cachetools import TTLCache, cached

calls = 0


@cached(cache=TTLCache(maxsize=100, ttl=2))
def load_settings(name):
    global calls
    calls += 1
    return {"name": name, "debug": False}


load_settings("prod")
load_settings("prod")
print("вызовов после двух обращений:", calls)
time.sleep(2.1)
load_settings("prod")
print("после истечения ttl:", calls)
вызовов после двух обращений: 1
после истечения ttl: 2Второй вызов в первые две секунды отдал запись из кэша, а после паузы функция отработала снова.
Внешний кэш в Redis
Все способы выше живут в памяти одного процесса. Если у сайта несколько воркеров или кэш должен пережить перезапуск, нужно внешнее хранилище, обычно Redis через клиент redis-py. Это уже отдельный сервер, и срок жизни ключа там задаётся при записи.
Как выбирать:
| Способ | Когда подходит |
|---|---|
@lru_cache(maxsize=N) |
Чистые функции, много разных аргументов, нужен потолок по памяти |
@cache |
Немного разных аргументов, например рекурсия по небольшому диапазону |
@cached_property |
Тяжёлый атрибут объекта, который не меняется после создания |
| Словарь вручную | Нужна своя логика ключа или выборочный сброс |
TTLCache из cachetools |
Данные устаревают: настройки, ответы API, курсы валют |
| Redis | Несколько процессов или серверов, кэш должен пережить перезапуск |
 Канал основателя Checkroi Вани БуявцаЗабирайте промпты и обучение по нейросетям в моём Телеграм-каналеБольше 3 800 человек уже применяют Claude Code, ChatGPT и другие нейросети в работе, учёбе, бизнесе и жизниПерейти в канал
Частые ошибки с lru_cache
Декоратор ставится одной строкой, поэтому его вешают и туда, где он ломает логику. Вот пять случаев, которые встречаются чаще всего.
TypeError: unhashable type: ‘list’
Кэш хранится в словаре, поэтому все аргументы должны быть хэшируемыми. Список, словарь и множество в ключ не годятся.
from functools import lru_cache


@lru_cache
def total(prices):
    return sum(prices)


print(total((100, 250, 40)))
try:
    total([100, 250, 40])
except TypeError as e:
    print("TypeError:", e)
390
TypeError: unhashable type: 'list'Решение: передавайте кортеж вместо списка или frozenset вместо множества. Чем они отличаются от изменяемых собратьев, мы разбирали в материале про множества в Python.
Изменяемый результат делится между вызовами
Кэш отдаёт не копию, а тот же самый объект. Если функция возвращает список и кто-то его поменял, испорченное значение получат все следующие вызовы:
from functools import lru_cache


@lru_cache
def default_tags(user):
    return ["новичок"]


tags = default_tags("anna")
tags.append("админ")
print(default_tags("anna"))
['новичок', 'админ']Решение: возвращайте кортеж или копируйте результат перед изменением: tags = list(default_tags("anna")).
Кэш на функции с побочными эффектами
Функция, которая пишет в файл, отправляет письмо или зависит от time() и random(), после кэширования сработает только один раз. В документации прямо сказано, что кэшировать такие функции нет смысла, как и генераторы с асинхронными функциями. Чем генератор отличается от обычной функции, есть в статье про yield.
Решение: кэшируйте только чистые вычисления, а запись и отправку выносите в отдельную функцию без декоратора.
RecursionError на большом аргументе
Кэш не отменяет глубину рекурсии. Первый вызов fib(5000) всё равно спускается на пять тысяч уровней, а лимит Python по умолчанию равен тысяче:
import sys
from functools import cache


@cache
def fib(n):
    return n if n < 2 else fib(n - 1) + fib(n - 2)


print(sys.getrecursionlimit())
try:
    fib(5000)
except RecursionError as e:
    print("RecursionError:", e)

for i in range(0, 5001, 500):
    fib(i)
print(len(str(fib(5000))))
1000
RecursionError: maximum recursion depth exceeded
1045Решение: прогрейте кэш снизу вверх, как в цикле выше, тогда каждый следующий вызов уходит вглубь не больше чем на 500 уровней. Другой путь — переписать функцию циклом. Повышать лимит через sys.setrecursionlimit() можно, но документация предупреждает, что слишком высокое значение может уронить интерпретатор.
Кэш на методе не даёт удалить объект
Если поставить @lru_cache на метод класса, в ключ попадает self. Кэш хранит ссылку на объект, и сборщик мусора его не удалит, пока запись не вытеснят:
import gc
import weakref
from functools import lru_cache


class Parser:
    @lru_cache(maxsize=None)
    def parse(self, line):
        return line.split(";")


p = Parser()
p.parse("a;b")
ref = weakref.ref(p)
del p
gc.collect()
print("объект жив:", ref() is not None)
print(Parser.parse.cache_info())
объект жив: True
CacheInfo(hits=0, misses=1, maxsize=None, currsize=1)Решение: для тяжёлых атрибутов берите cached_property, а кэш методов делайте с ограничением maxsize. Варианты разобраны в FAQ Python о кэшировании методов.
lru_cache в 16 задании ЕГЭ по информатике
Школьники ищут lru_cache из-за задания 16: в нём нужно вычислить значение рекурсивно заданной функции. По методическим рекомендациям ФИПИ на 2026 год, задание проверяет умение вычислять рекуррентные выражения.
Возьмём учебную задачу в духе экзамена: F(1) = 1, а при n > 1 F(n) = n · F(n − 1). Нужно найти F(2026) / F(2024). В лоб такая рекурсия упрётся в лимит глубины, а с кэшем и прогревом считается за доли секунды:
from functools import lru_cache


@lru_cache(maxsize=None)
def F(n):
    if n == 1:
        return 1
    return n * F(n - 1)


for i in range(1, 2027):
    F(i)

print(F(2026) // F(2024))
print(2026 * 2025)
4102650
4102650Вторая строка вывода важнее первой. ФИПИ советует сначала упростить выражение: F(2026) / F(2024) сокращается до 2026 · 2025, и программа не нужна вовсе.
В тех же рекомендациях сказано, что при больших N рекурсивная программа либо работает очень долго, либо завершается аварийно. Если видите превышение допустимого числа рекурсивных вызовов, ищите способ упростить формулу.
Кэш хорош, когда упростить не получается, а подзадачи повторяются. Ещё 30 задач на функции и циклы для тренировки собраны в подборке задач по Python для начинающих.
Когда кэш ускоряет программу, а когда нет
Кэш выигрывает время, только если одни и те же аргументы повторяются. Функция, которую каждый раз зовут с новым значением, с декоратором станет чуть медленнее: добавится поиск по словарю и расход памяти.
- Рекурсия с перекрывающимися подзадачами: числа Фибоначчи, задачи на динамическое программирование.
- Тяжёлые вычисления по небольшому набору входов: разбор конфигов, справочники, регулярные выражения.
- Запросы к медленным источникам, если данные можно считать неизменными какое-то время. Здесь лучше TTL.
Перед тем как вешать кэш, замерьте время через time.perf_counter(), как в первом примере, а после посмотрите cache_info(). Если попаданий почти нет, декоратор лишний. Другие способы ускорить код, от PyPy до компиляции, собраны в статье про компилятор Python.
Где освоить Python системно
Кэширование на курсах Python-разработки проходят вместе с декораторами, алгоритмами и оптимизацией. Если хочется разобраться с языком последовательно, а не по отдельным задачам, сравните программы в каталоге курсов Python.
| Курс | Школа | Стоимость со скидкой | В рассрочку | Длительность | Обзор курса от Checkroi |
|---|---|---|---|---|---|
| Профессия «Python-разработчик» Перейти на сайт курса |  Skillbox | 157 335 ₽ | 5987 ₽/мес. | 10 месяцев | Обзор курса |
| Fullstack-разработчик на Python Перейти на сайт курса |  Нетология | 137 000 ₽ | 7125 ₽/мес. | 21 месяц | Обзор курса |
| ДО Профессия Python-разработчик Перейти на сайт курса |  GeekBrains | 149 001 ₽ | 3167 ₽/мес. | 10 месяцев | Обзор курса |
| Автоматизированное тестирование на Python Перейти на сайт курса | Skillbox | 118 754 ₽ | 4108 ₽/мес. | 9 месяцев | Обзор курса |
| Профессия Python-разработчик Перейти на сайт курса |  SkillFactory | 140 040 ₽ | 3890 ₽/мес. | 10 месяцев | Обзор курса |
Больше программ — в полном каталоге курсов по Python